大家好,我是 Jax,一名计算机专业大三学生、独立开发者,也是一个沉迷 Vibe Coding 的产品型开发者。在抖音上,我叫“草台玩家 Jax”。
我对 LLM、Agent 架构和软件产品设计一直很感兴趣。做产品时,我更习惯扮演“产品经理+设计师”:先定义问题、拆解用户路径、判断方案取舍,再让 TRAE 承担全栈实现、代码诊断和工程验证。
初赛时,我用几天时间完成了“全知视界”的第一个 Demo;复赛阶段,我没有继续简单增加几张卡片,而是重新追问了一个问题:
当一次搜索结束之后,那些找到的知识,能不能被保存、连接,并成为下一次探索的起点?
这也让 OmniVision 从一个“生成情报看板的 Demo”,逐步成长为一套完整的 AI 原生知识探索系统。
团队介绍
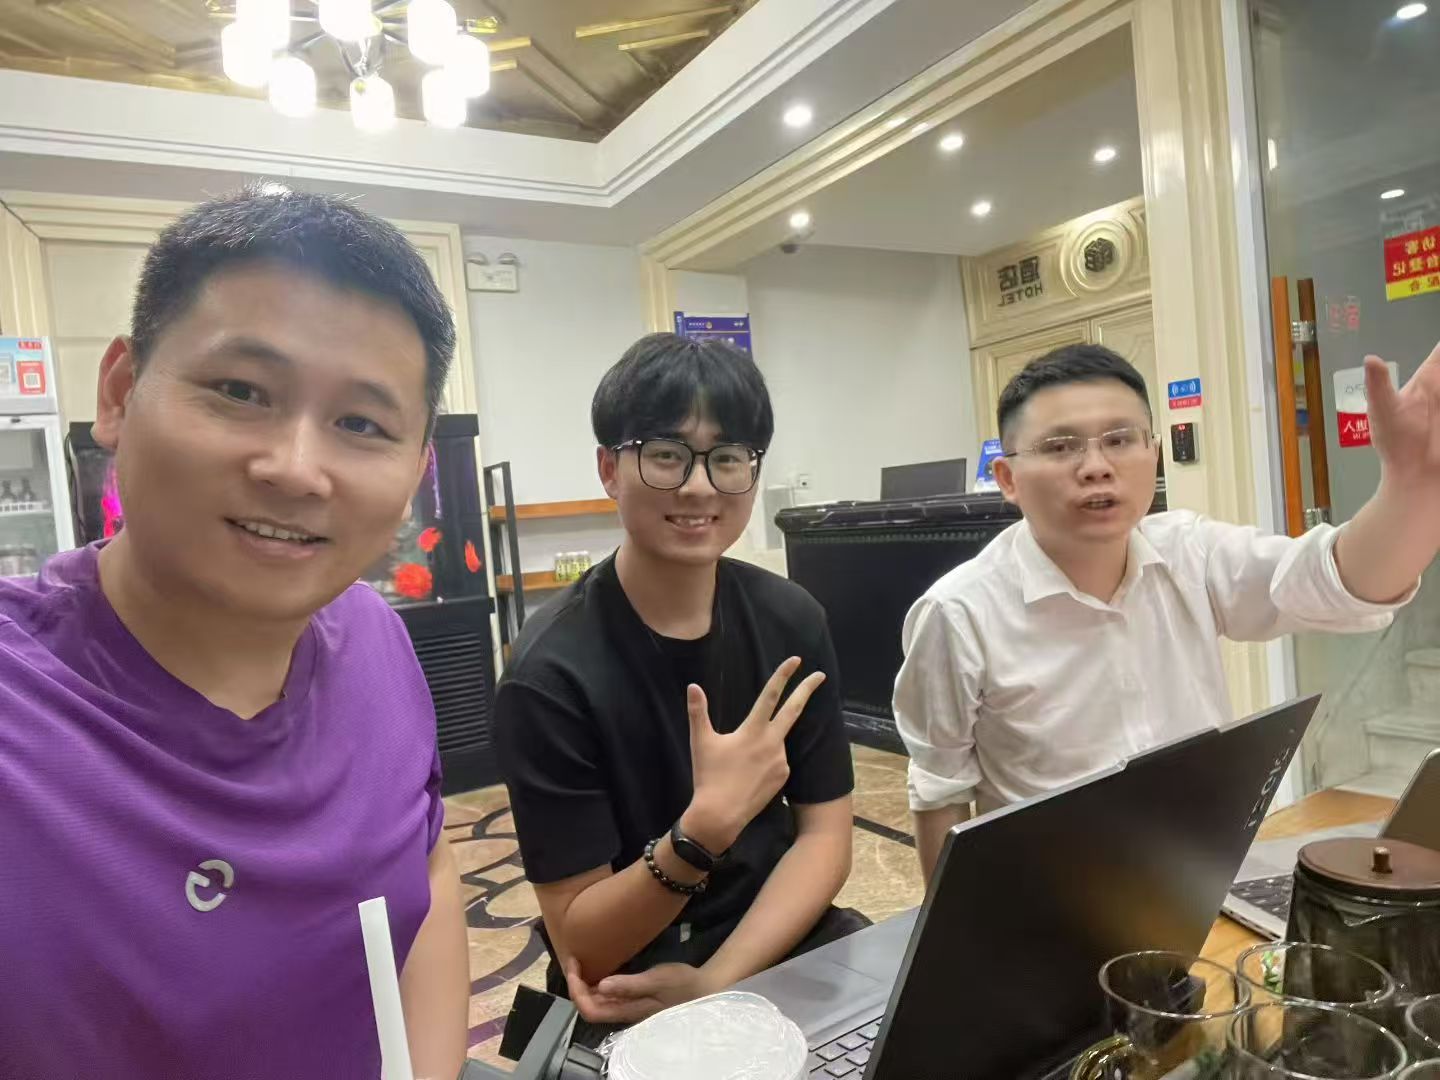
队伍名称:三人行 一句话定位:一个学生开发者的产品原点,两位资深营销人的方向感——我们互为彼此的老师。
我们是谁
李昊烜(Jax)|队长·产品设计&全栈开发
中国计量大学计算机专业大三学生、独立开发者,抖音账号“草台玩家 Jax”。
作为一个沉迷 Vibe Coding 的产品型开发者,我对 LLM、Agent 架构以及 AI Native 的软件产品设计有着极高的热情。在独立开发中,我习惯先以产品经理和设计师的视角定义问题、拆解用户路径、权衡架构方案,再借助 AI 辅助编码与工程验证,高效实现从 0 到 1 的全栈落地。从算法实习、金融数据链路处理到完整项目全栈部署,我始终坚持用技术解决真实的交付与体验问题。
在本次大赛中,我独立负责了产品全流程的思想构建、UI/UX 设计与完整技术架构搭建。初赛阶段,我仅用几天时间便敏捷开发并上线了“全知视界”的第一个 Demo;进入复赛后,我没有止步于 UI 样式的简单堆叠,而是重新追问本质——“一次搜索结束之后,如何让知识被妥善保存、连接,并成为下一次探索的起点?”这一思考驱动 OmniVision 从一个简单的情报看板 Demo,演进为一套完整的 AI 原生知识探索系统(包含扩展图谱的功能关联等关键创新)。
我深知纯技术 Demo 与商业化产品之间的距离。在团队中,我不仅是核心研发的“一线推进者”,更是跨代际、跨专业知识的吸收者。通过与两位资深营销与增长专家的深度碰撞,我正尝试融合敏捷技术实现力与严谨的市场商业逻辑,用“草台”的真诚去搭一件真正解决用户痛点的“全知”之事。
吕海涛|用户增长&产品市场化 长期扎根用户增长与产品市场化方向。在团队里负责从“用户使用侧”和“商业化落地”两个角度给产品找方向——一个功能做得再酷,如果用户用不起来、跑不通商业化路径,就还差一口气。我和Jax最早是在赛事初赛的交流群里,因为互相分享自己做产品的经验而认识 的。
徐伟良|产品营销战略 互联网营销12年的老兵,巨量学讲师、腾讯创意营销师。服务过三只松鼠、联合利华、全棉时代、维达、元气森林、白小T、海澜之家等品牌,横跨食品饮料、生活日化、护肤美妆、本地生活。在团队里,他帮我们快速校准产品未来该往哪走,带着一起挖“这款产品到底在解决哪些用户的哪些真实痛点”,并坚持从小处 切入。
我们怎么 走到一起
故事的开头很普通。我和海涛哥在一个跟比赛初赛的交流群里认识,常常互相分享做产品的经验。聊得多了,我发现他在用户增长和产品市场化落地上的积累,正好补上我最缺的那一块。于是进复赛的时候,我第一个想到的就是邀请海涛哥入队,希望他能从用户侧和商业化落地这两个角度,帮我把产品 拉回地面。
后来海涛哥带着他的好兄弟伟良哥,专程来杭州线下跟我见了一面,吃了顿饭。那顿饭让我重新认识了什么叫“专业”——伟良哥用很短的时间,就帮我精确锁定产品未来的方向,带着我一层层往下挖:这款产品到底在解决谁的什么真实痛点,又该从哪个最小的切口先动手。“从小处切入”,这句话后来几乎成了我们讨论产品 时的口头禅。
在我眼里,这两位老师既是这支队伍的“智谋团”,也是产品功能探索上的共创者。大方向的定义、产品未来的规划与发展,他们给了我最关键的把关;而在新功能的探索里,他们也提了不少关键而宝贵的建议——产品扩展图谱的“功能关联”这个重要节点,就是在我们的交流中被发现的。当然,产品的想法、设计和整套技术实现,主要还是我在一线推进。一老一少、技术与营销跨界,方向与功能上互为补位、落地实现由我承担——这是我们最自然的分工,也是这支队伍 最真实的模样。
我们不一样的地方
这支队伍的底色,是一个年轻开发者在路上遇到了两位愿意倾囊相授的老师:海涛补上了“产品怎么落地、怎么增长”的短板,伟良补上了“产品该往哪走、该解决谁的真问题”的判断,而在产品功能探索上,他们也和我一起碰撞出了像“扩展图谱功能关联”这样的关键节点。技术能造出Demo,但让Demo长成一个真正被用户用起来、能跑通商业化的产品,靠的是这种跨代际、跨专业的互补。我们想做的,是用“草台”的真诚,去认真搭一件" 全知"的事。
一、产品简介
1. OmniVision 是什么?
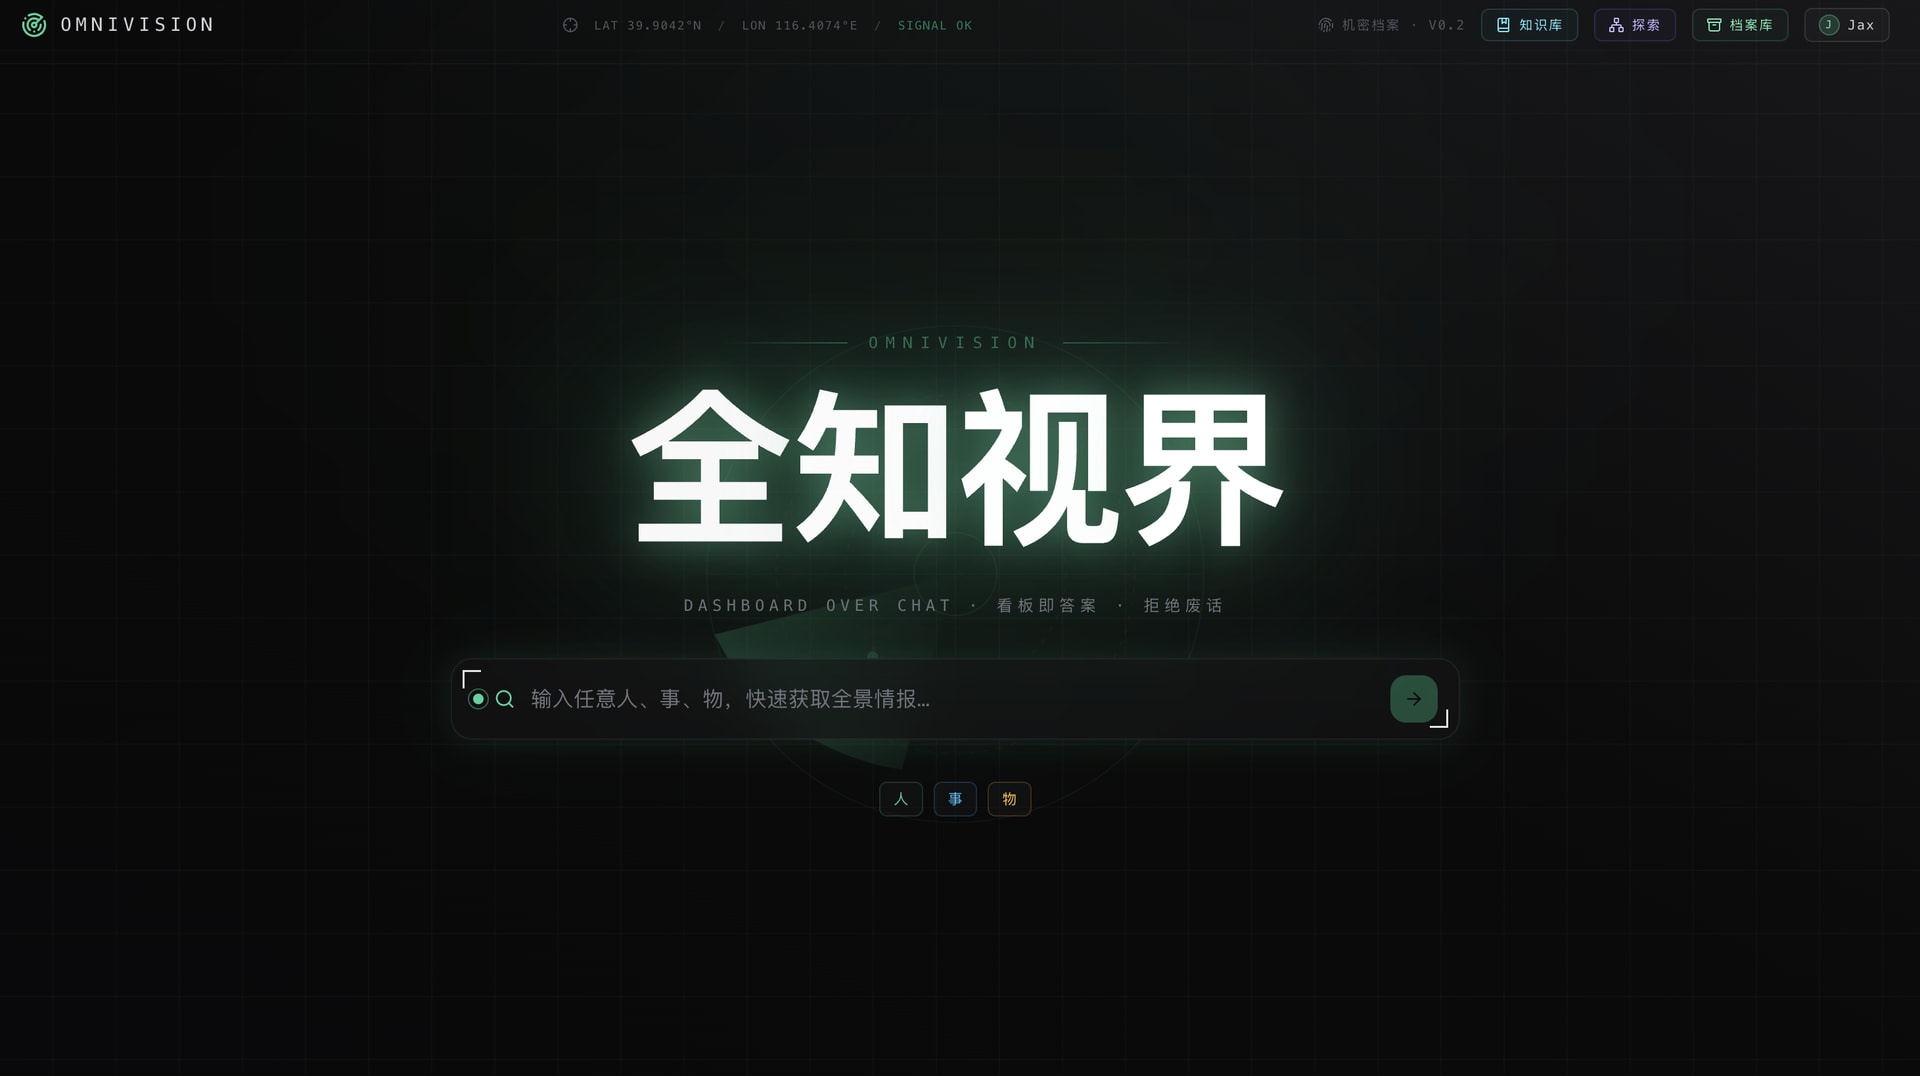
OmniVision 全知视界是一款面向学习、研究和决策准备场景的 Web 端 AI 情报工作台。
用户输入一个人物、事件或事物,系统通过多信源研究生成六维情报看板,再把有价值的结论沉淀为个人知识库、专题知识图谱和可持续追问的探索图谱。
一句话概括:
OmniVision 把一次零散搜索,变成可核验、可回溯、可保存、可继续生长的个人认知资产。
它不是替用户给出一个“标准答案”,而是把散落在互联网中的碎片,整理成一张有来源、有正反面、有时间脉络和利益关系的认知地图。
2. 面向谁?
OmniVision 的核心用户,是需要快速进入陌生议题,并把零散信息转化为理解、内容或决策的知识工作者。
典型场景包括:
- 大学生做课程报告、课题调研,快速建立陌生领域的知识框架;
- 内容创作者追踪热点人物与事件,梳理时间线、争议和利益相关方;
- 产品、市场和运营人员进行竞品研究、人物背景调查和行业分析;
- 研究人员完成正式研究前的线索发现与“研究前侦察”;
- 普通用户面对复杂公共议题时,查看来源、分歧与不同立场,降低被片面信息误导的可能。
OmniVision 不替代正式的系统性文献综述,也不替用户决定应该相信什么。它希望降低“形成可靠认知”的门槛,让更多人能够基于证据形成自己的判断。
二、完整用户路径
OmniVision 的核心流程是:
提出问题
→ 实体识别、歧义澄清与风险保护
→ 六维多信源研究
→ 生成结构化情报看板
→ 追问、深挖、对比与关联搜索
→ 收藏进个人知识库
→ 按专题建立文件夹
→ 生成专题图谱和总知识图谱
→ 选择任意实体继续探索
→ 回溯、归档与导出
搜索不再是流程的终点,而是知识生长的起点
三、完整功能
1. 智能研究入口
用户可以输入任意人物、事件或事物。系统会先判断对象类型和搜索意图:
- 多义词触发实体消歧,避免“苹果”到底是公司还是水果之类的误搜;
- 支持“A 对比 B”等双实体对比任务;
- 前后端双层风险识别,对高风险主题进行拦截或限制信源;
- 搜索面包屑和结果快照支持快速回到之前的研究结果。
2. 六维多信源研究引擎
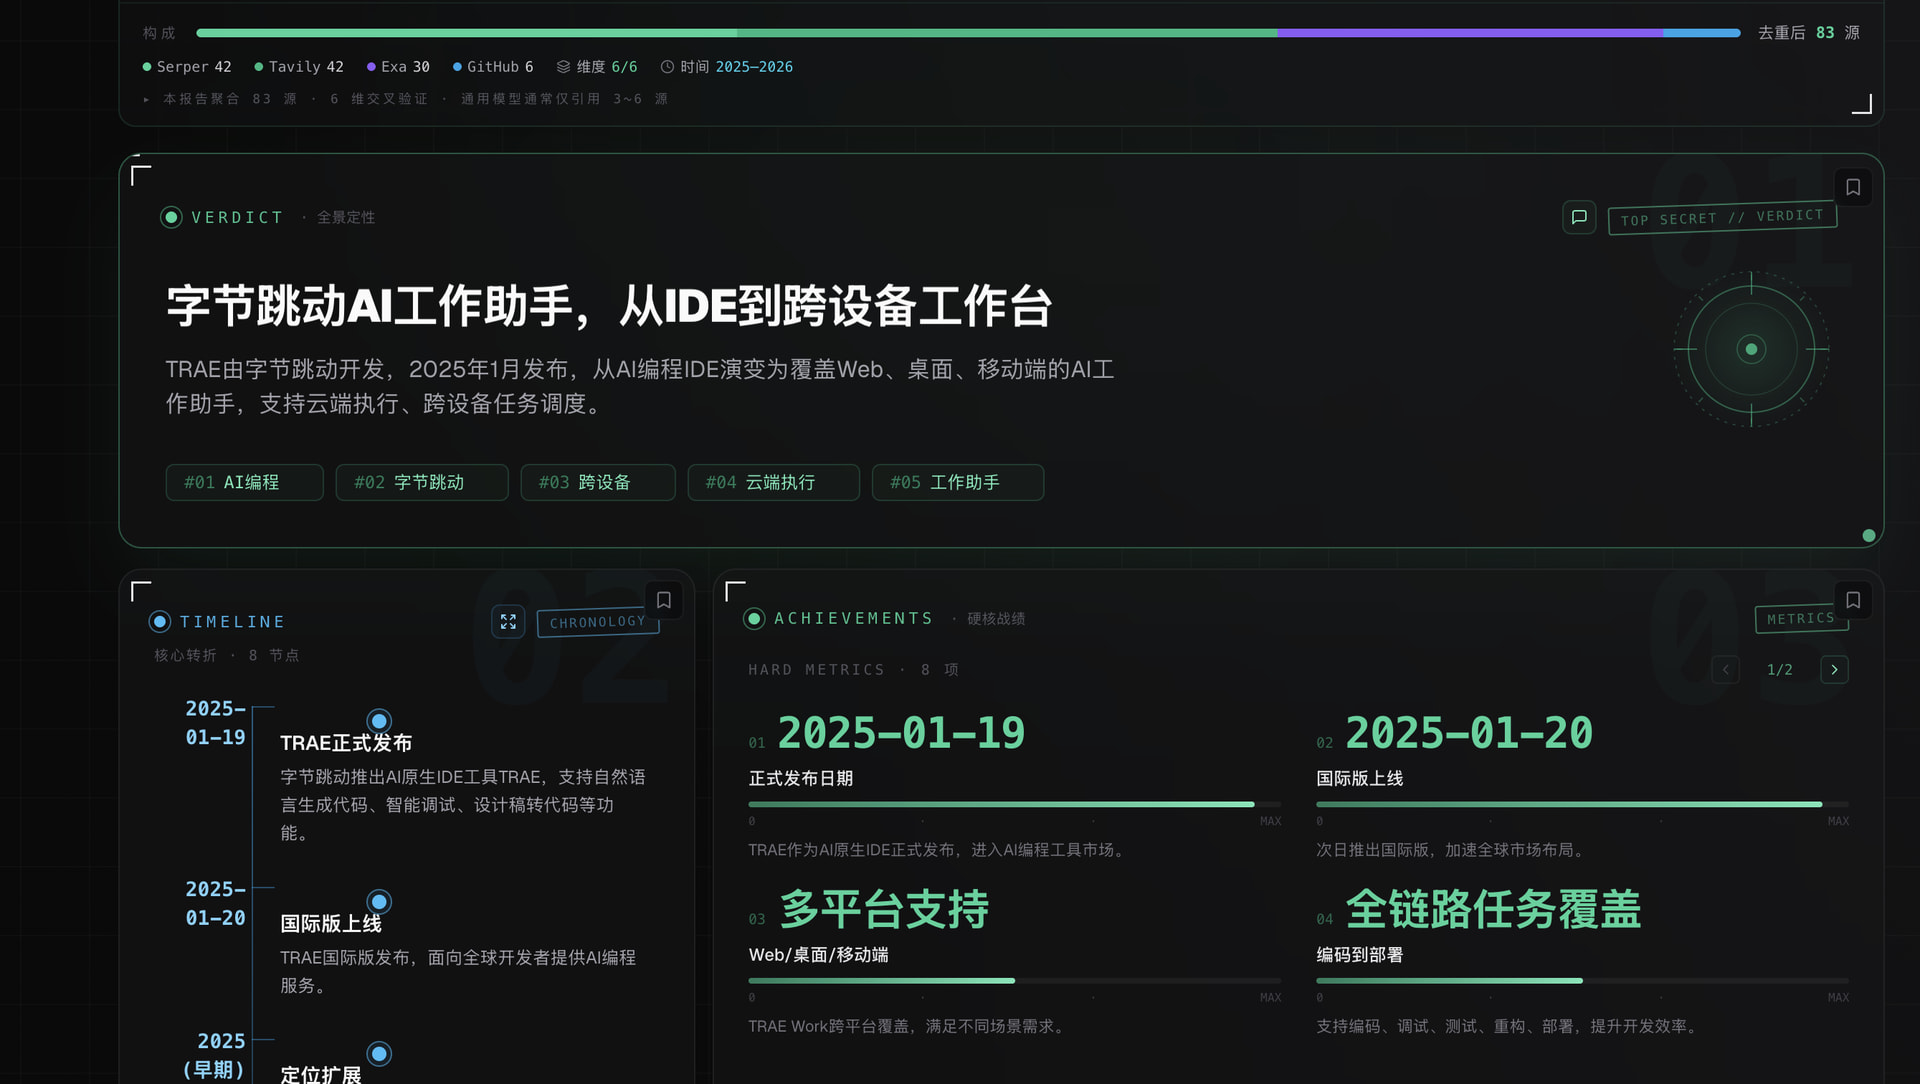
系统把一个问题拆解为六个研究维度:
- 全景定性:它是谁、是什么;
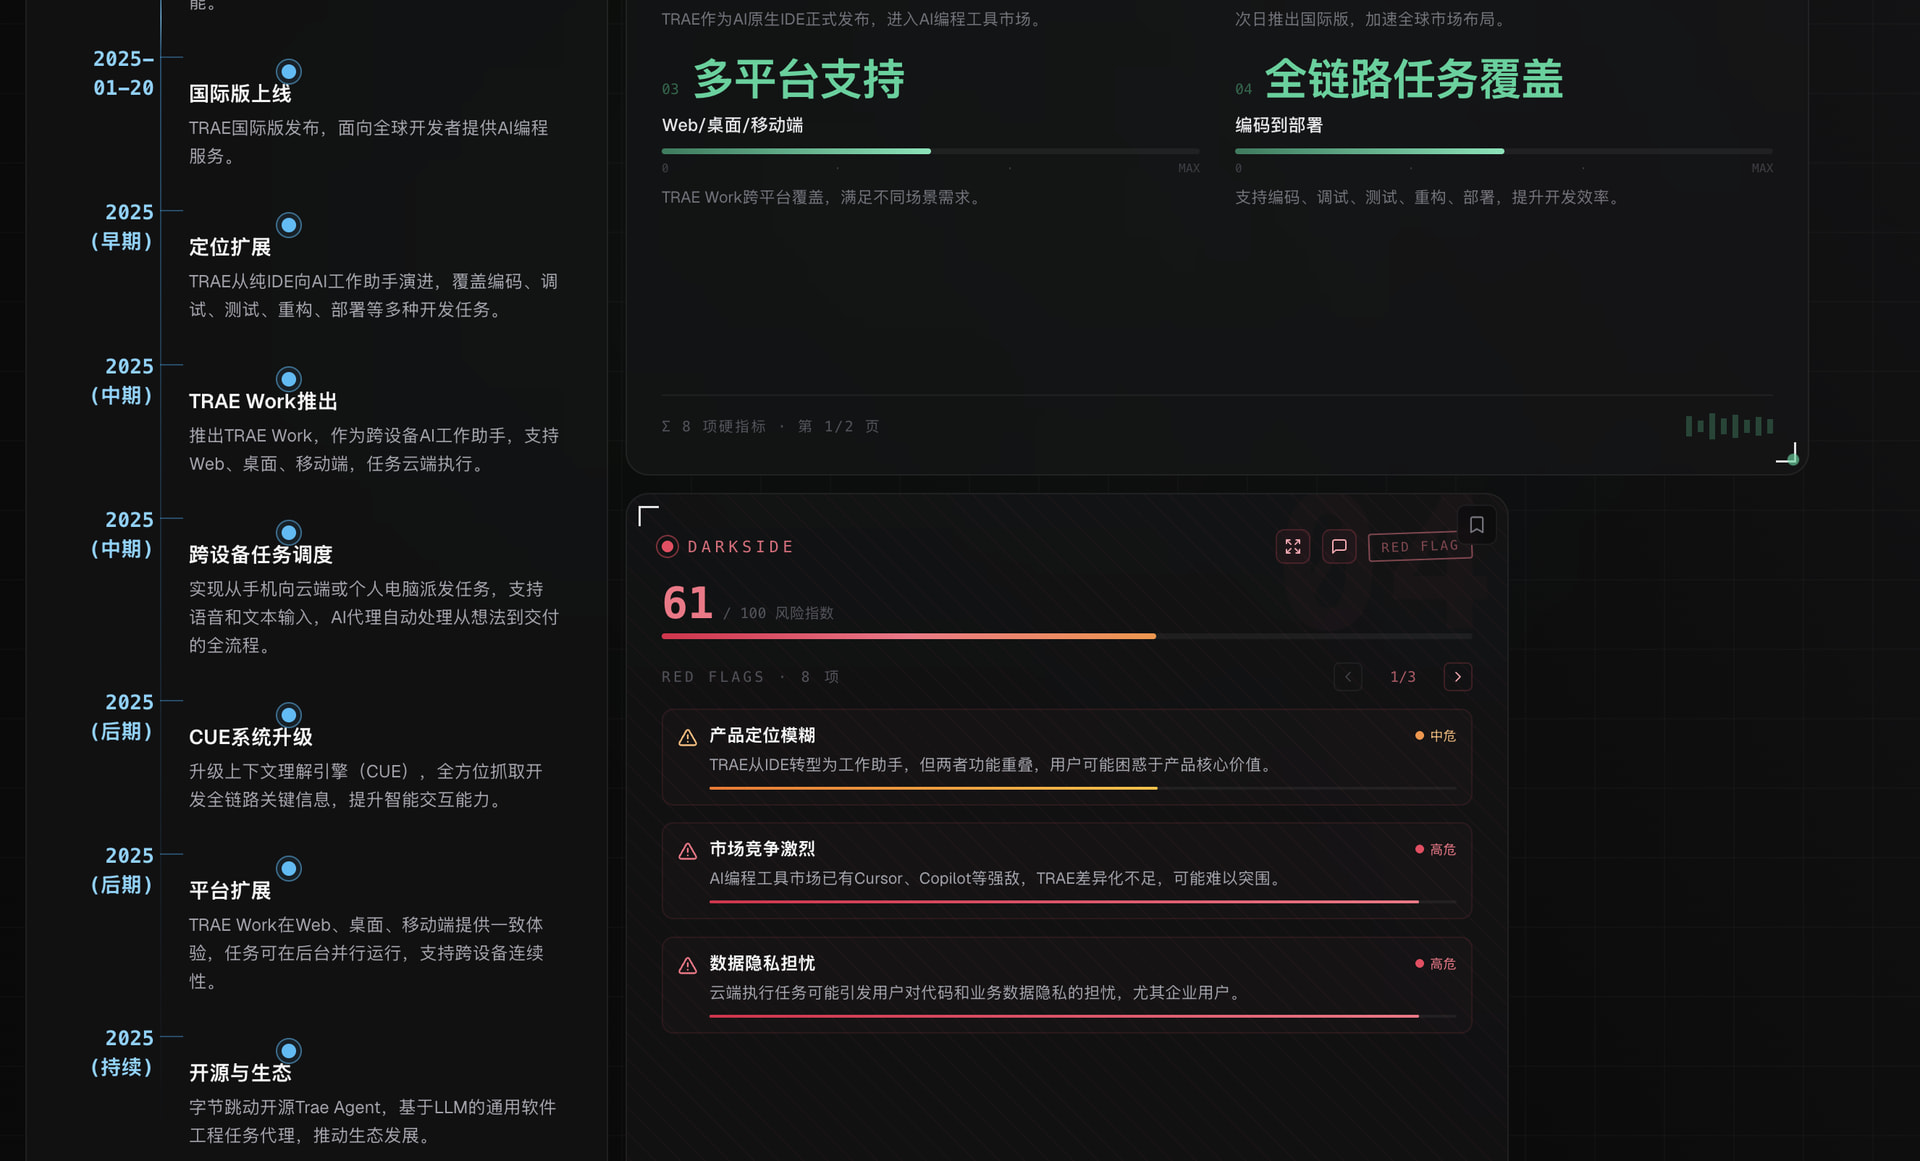
- 核心时间线:它经历了哪些关键节点;
- 成就数据:有哪些可量化成果;
- 趋势分析:数据和影响如何变化;
- 反向视角:存在哪些争议、风险与反例;
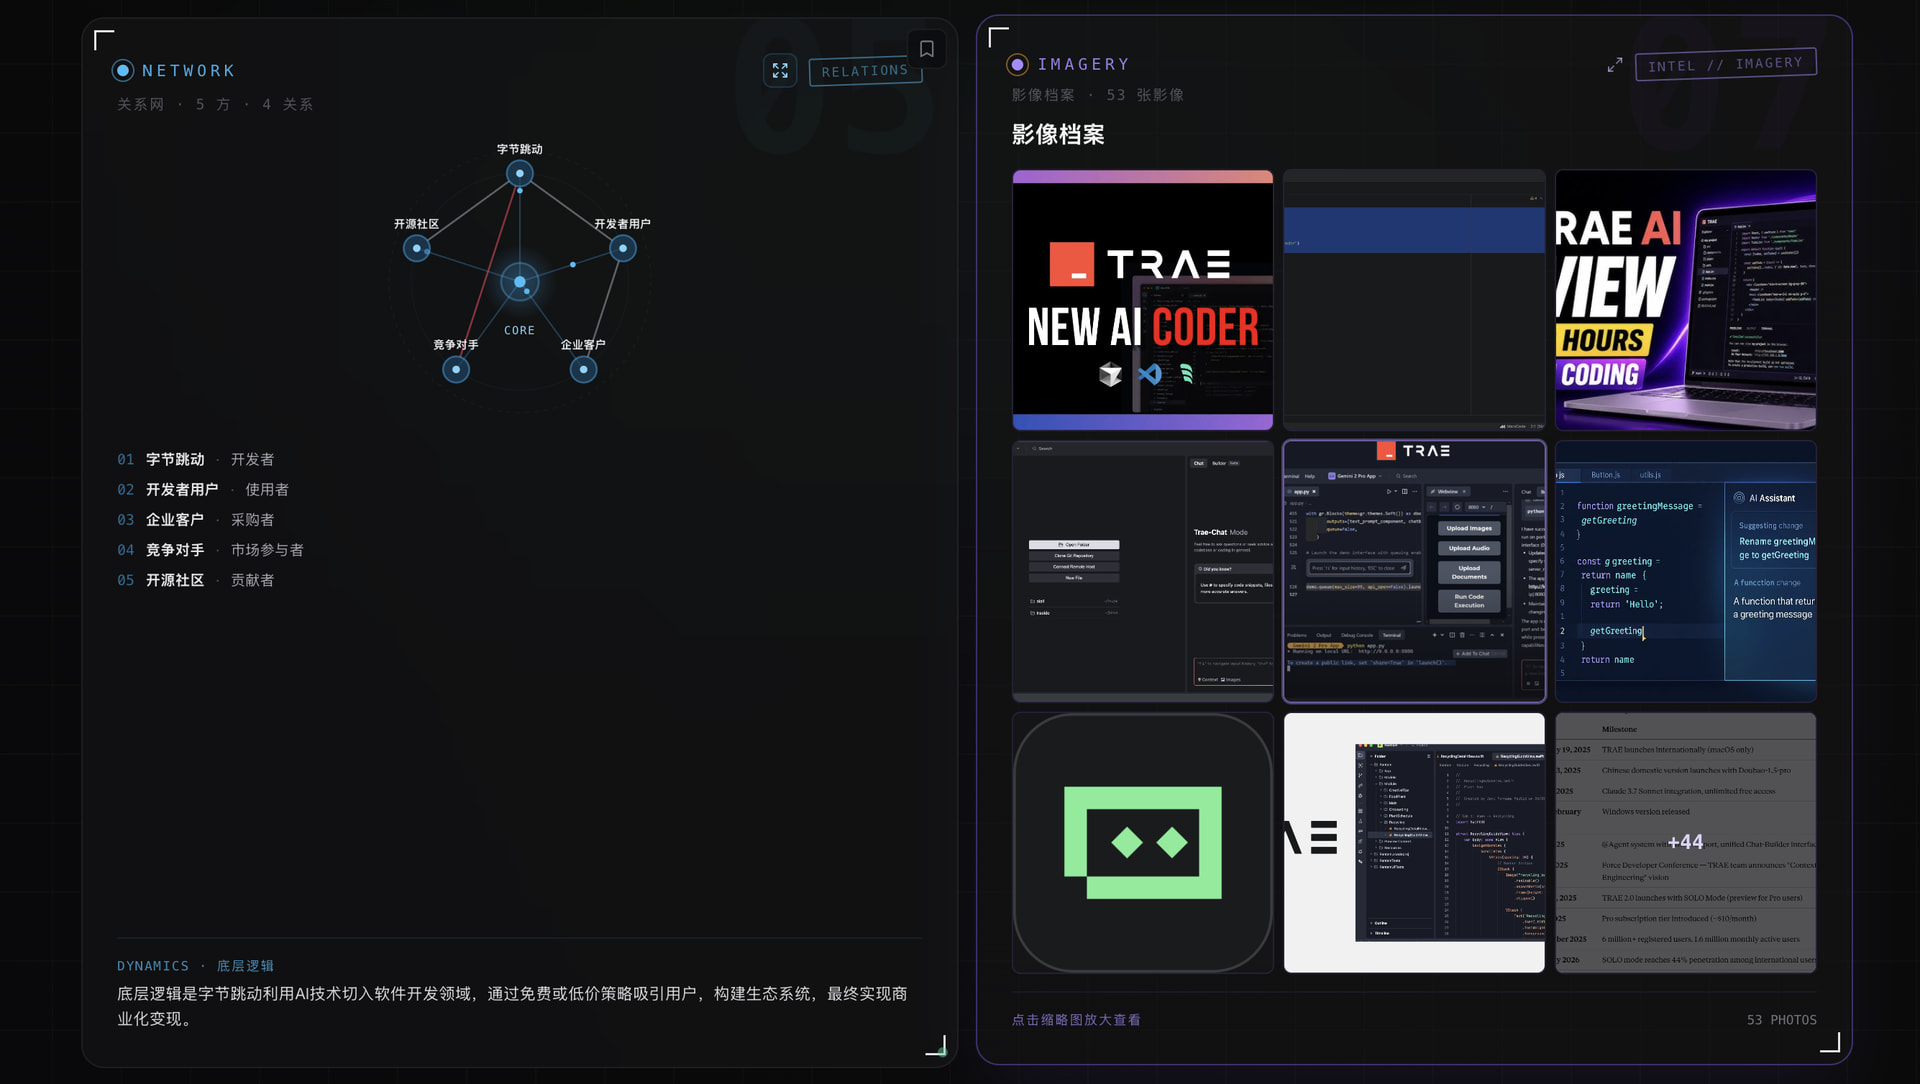
- 关系博弈:参与者之间如何合作、竞争或监管。
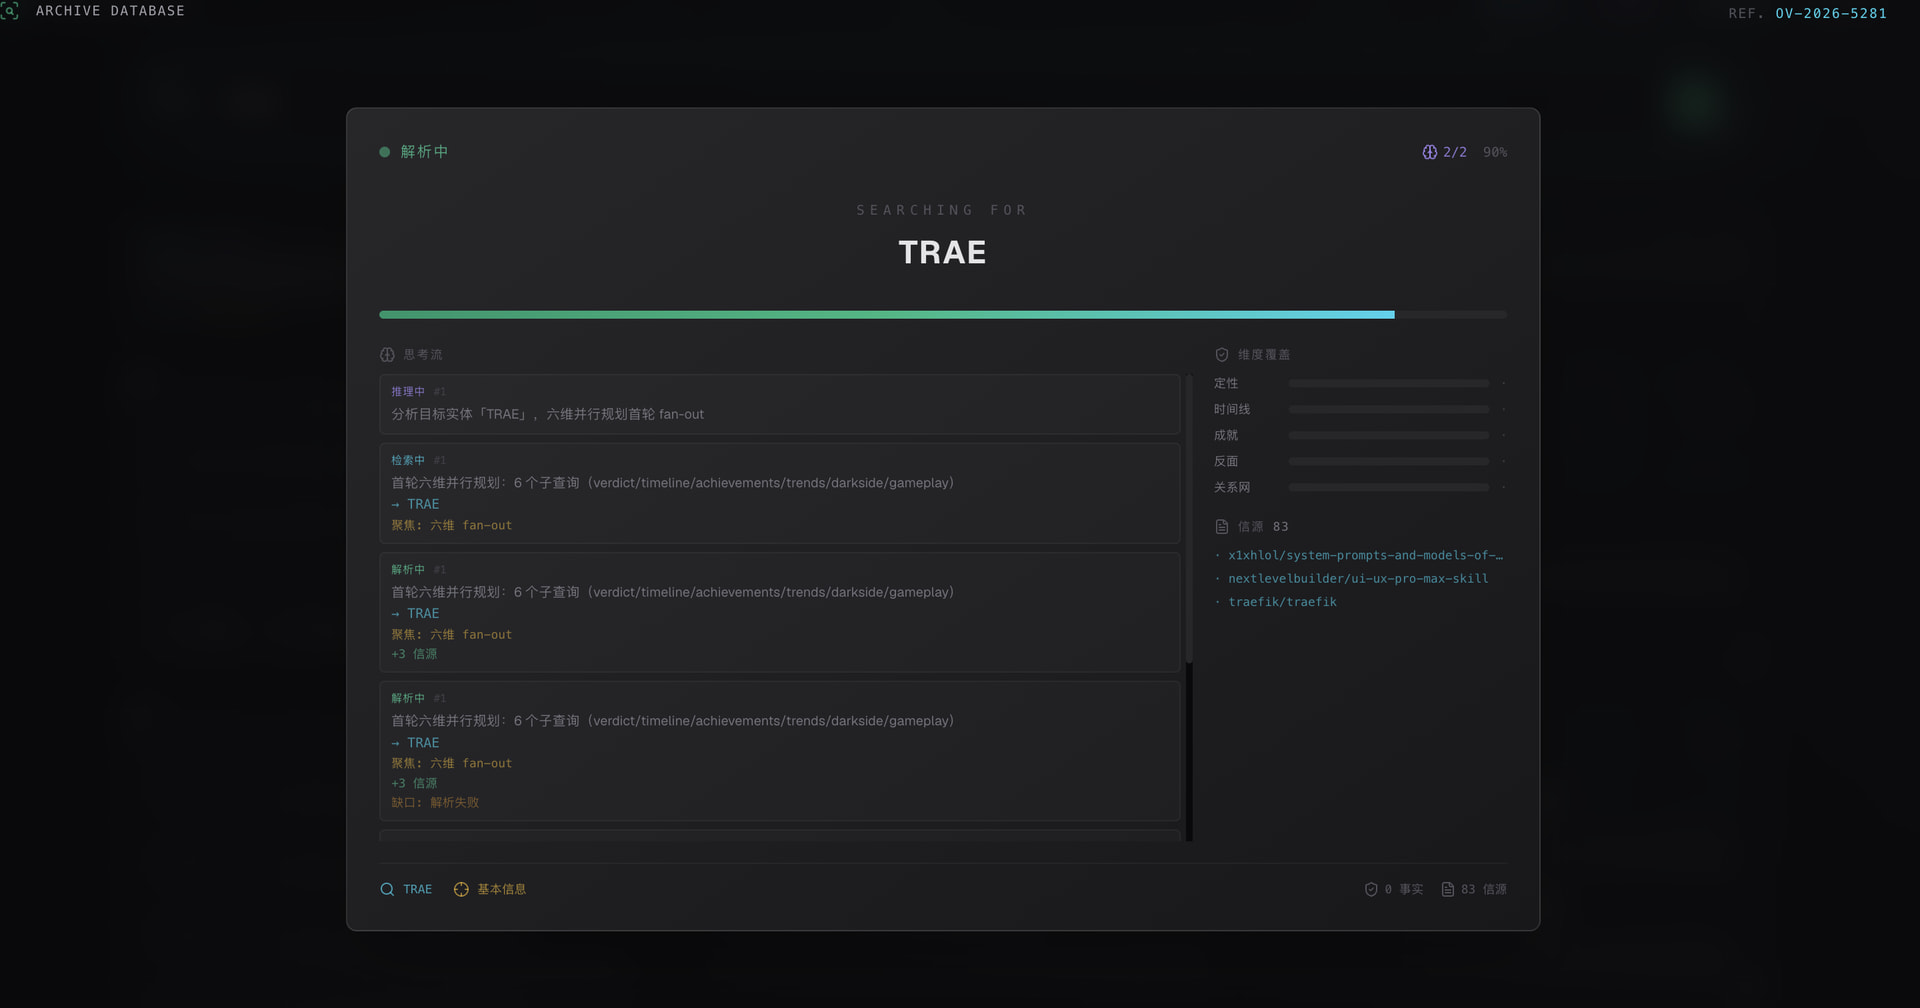
复赛版本已经实现可插拔的多信源架构,可根据配置启用 SearXNG、Serper、Tavily、Exa、DuckDuckGo、GitHub 和 Openverse 等适配器。
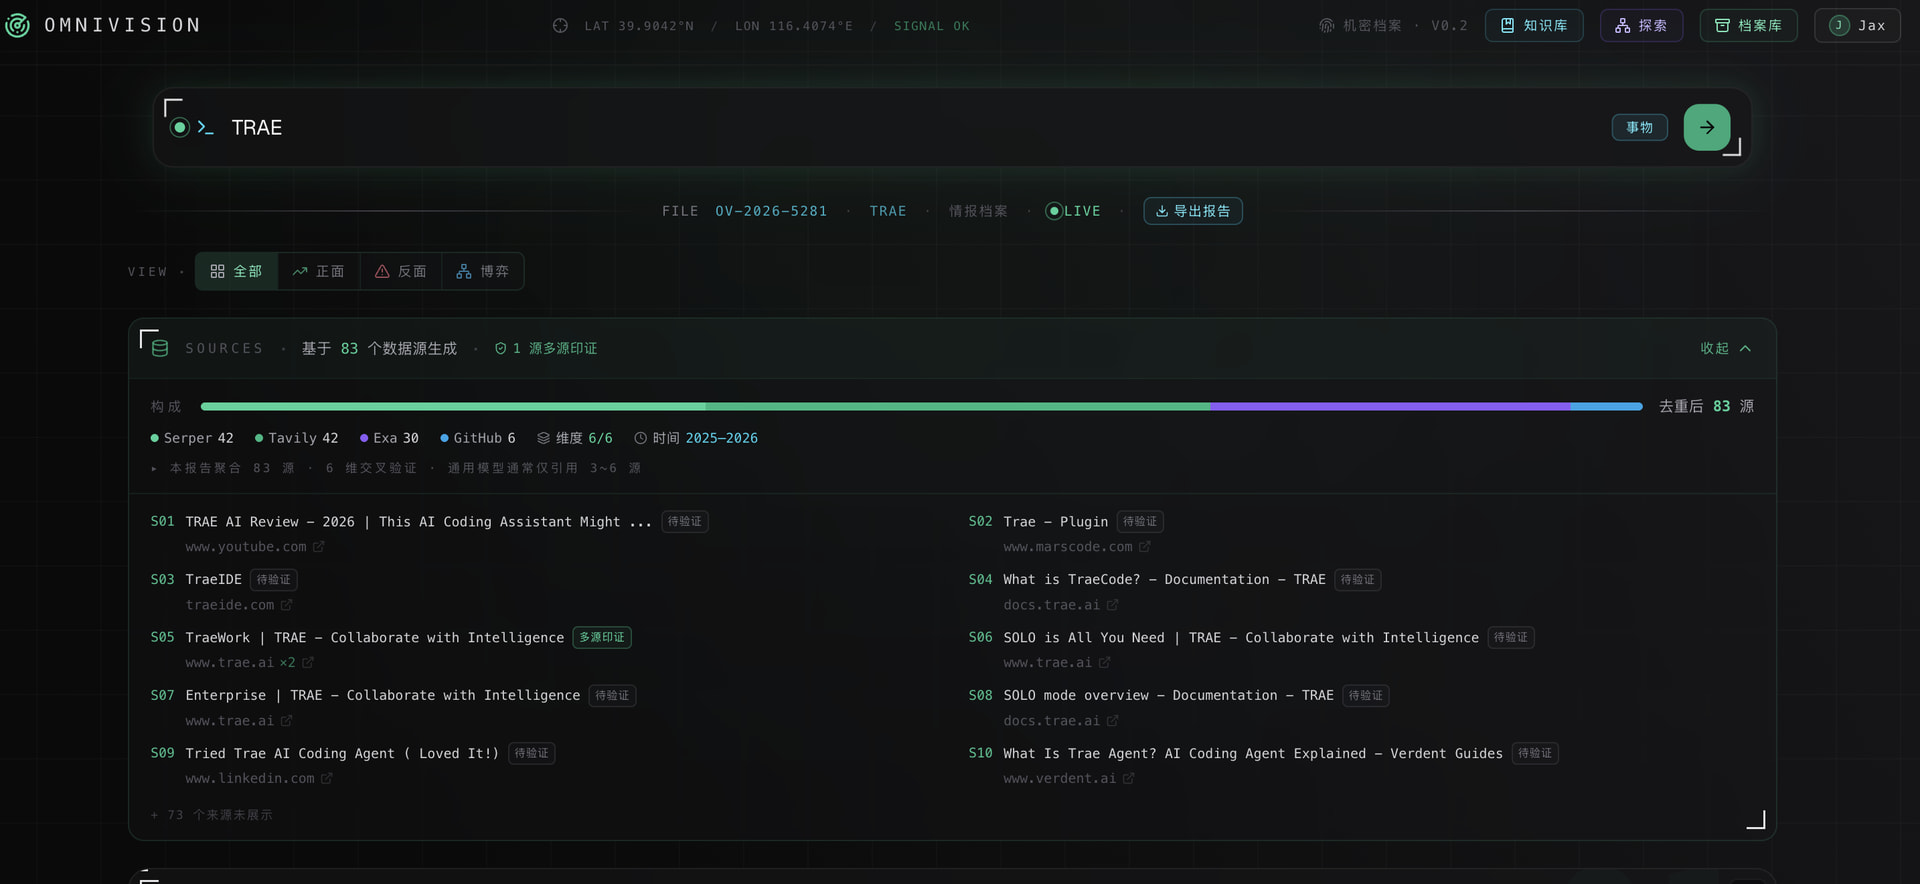
召回的信息会经过 URL 去重、RRF 融合排序、域名权威度评估与跨源置信度计算,再通过 SSE 流式推送到前端。用户可以看到研究进度、来源构成、覆盖维度、时间跨度与证据入口,而不只是看到一段无法解释来源的 AI 回答。
3. 可交互的情报看板
研究结果被整理成定性研判、时间线、成就数据、趋势数据、风险争议、关系博弈和影像档案。
用户可以:
- 切换全部、正向、批判和博弈视角;
- 展开时间线、风险与关系卡片;
- 围绕关键研判和风险内容继续追问;
- 聚焦时间线节点并跳转相关内容;
- 点击标签发起关联搜索;
- 将有价值的卡片收藏进知识库;
- 导出带来源的 HTML 情报报告。
4. 个人知识库与专题管理
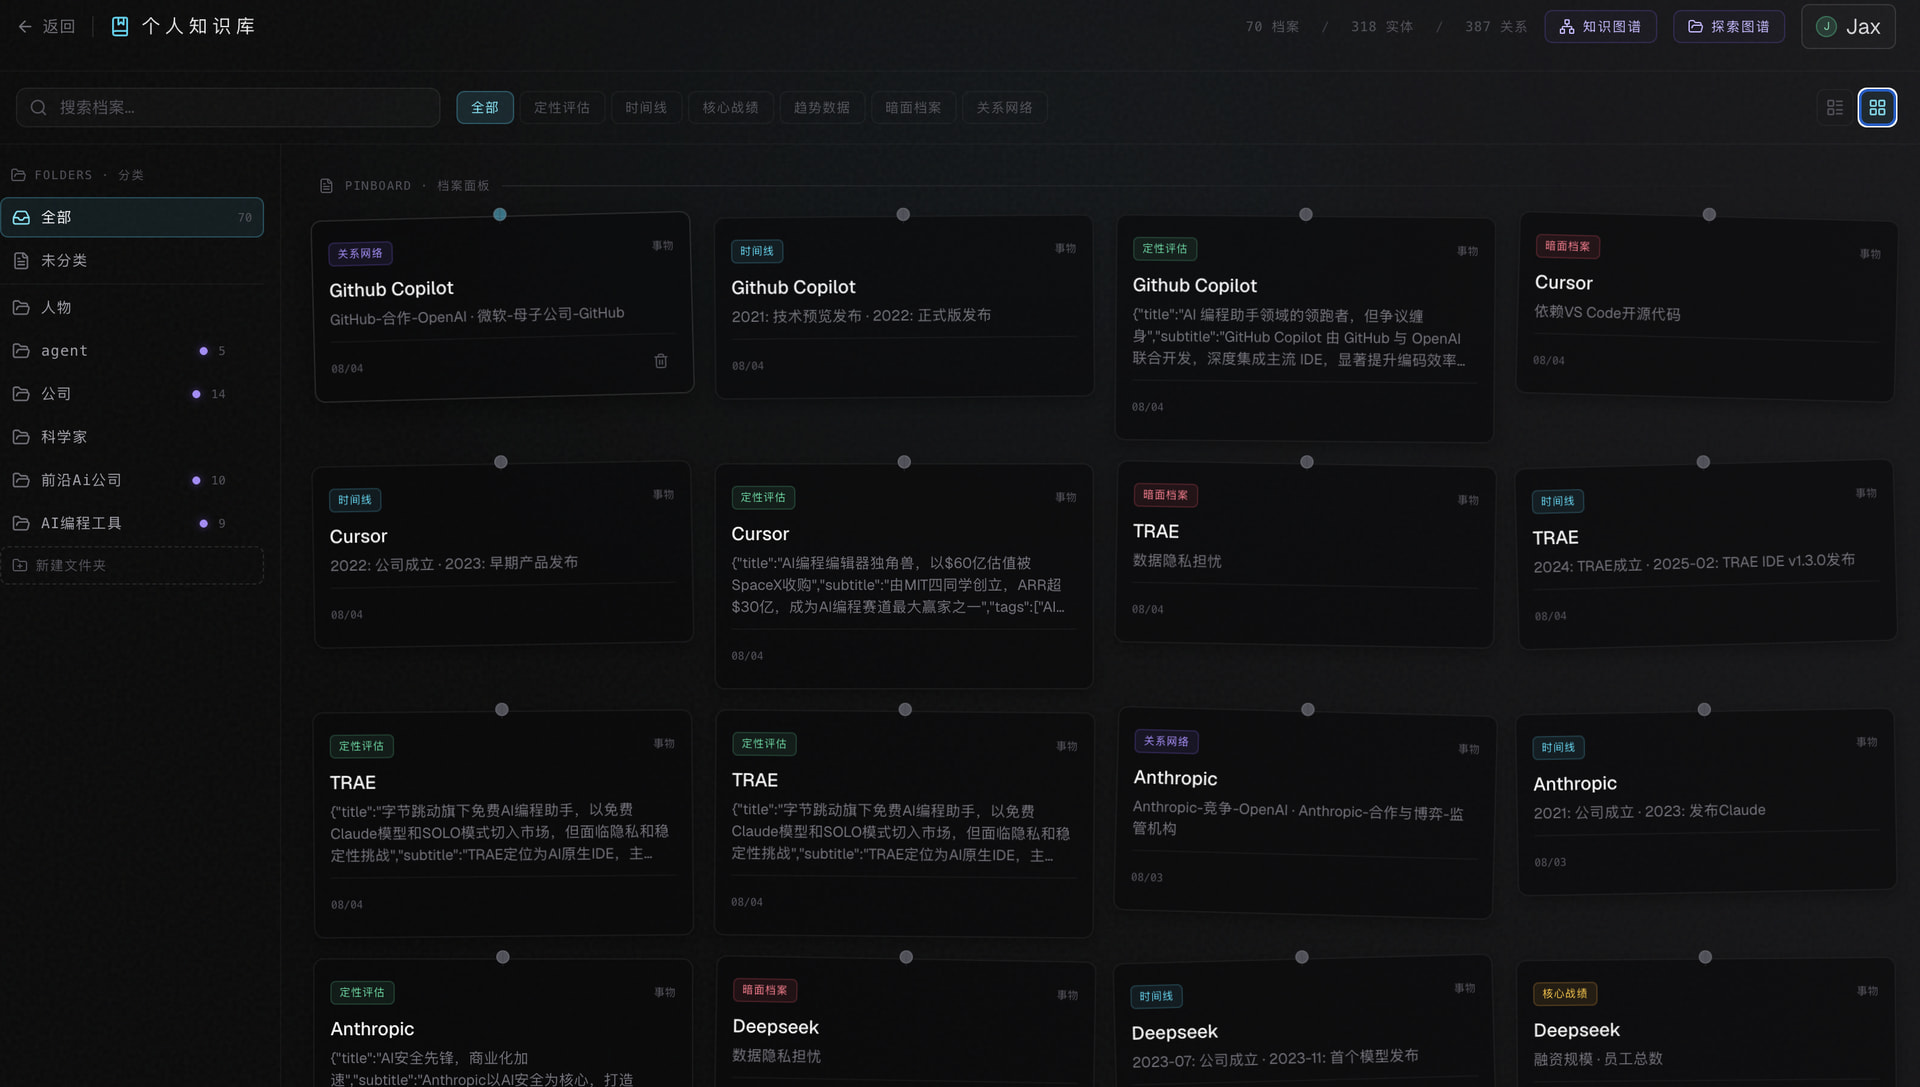
登录后,用户可以将研究中有价值的卡片保存到个人知识库。
知识库支持:
- 按关键词检索;
- 按六类卡片类型筛选;
- 按文件夹或未分类内容筛选;
- 新建专题文件夹;
- 查看卡片详情;
- 统计卡片、实体和关系数量。
过去看完即消失的 AI 回答,从这里开始变成可以检索、分类和长期积累的个人知识资产。
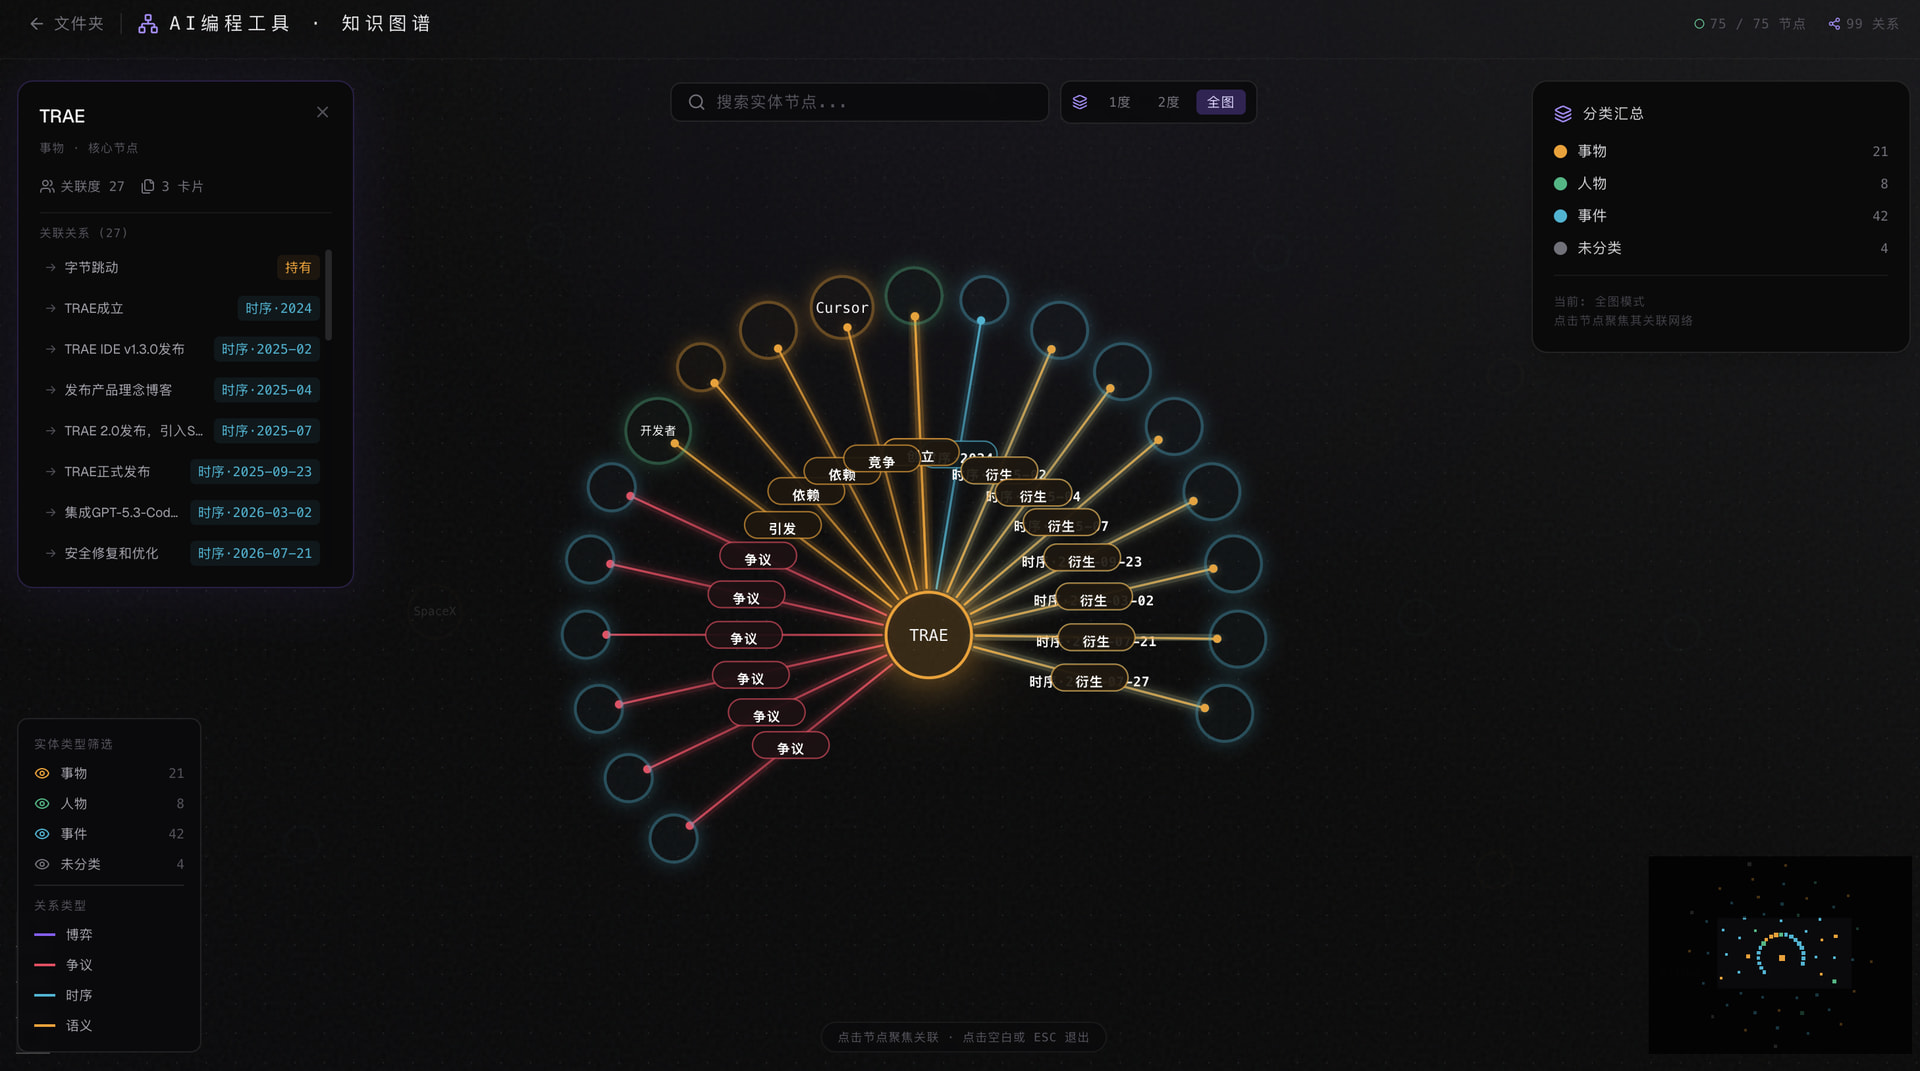
5. 三层知识图谱
OmniVision 中的三种图谱分别承担不同任务。可以把它们理解成三张不同尺度的地图:
- 总知识图谱像“整座城市的交通网”,连接用户收藏的全部内容;
- 文件夹图谱像“一个城区的专题地图”,聚焦某个研究主题;
- 探索图谱像“边走边画的新路线”,用户从一个实体出发,通过持续提问生成新节点和关系。
图谱支持实体搜索、节点聚焦、关系深度切换、类型筛选、缩放、小地图和关系链查看。
6. 可持续生长的探索图谱
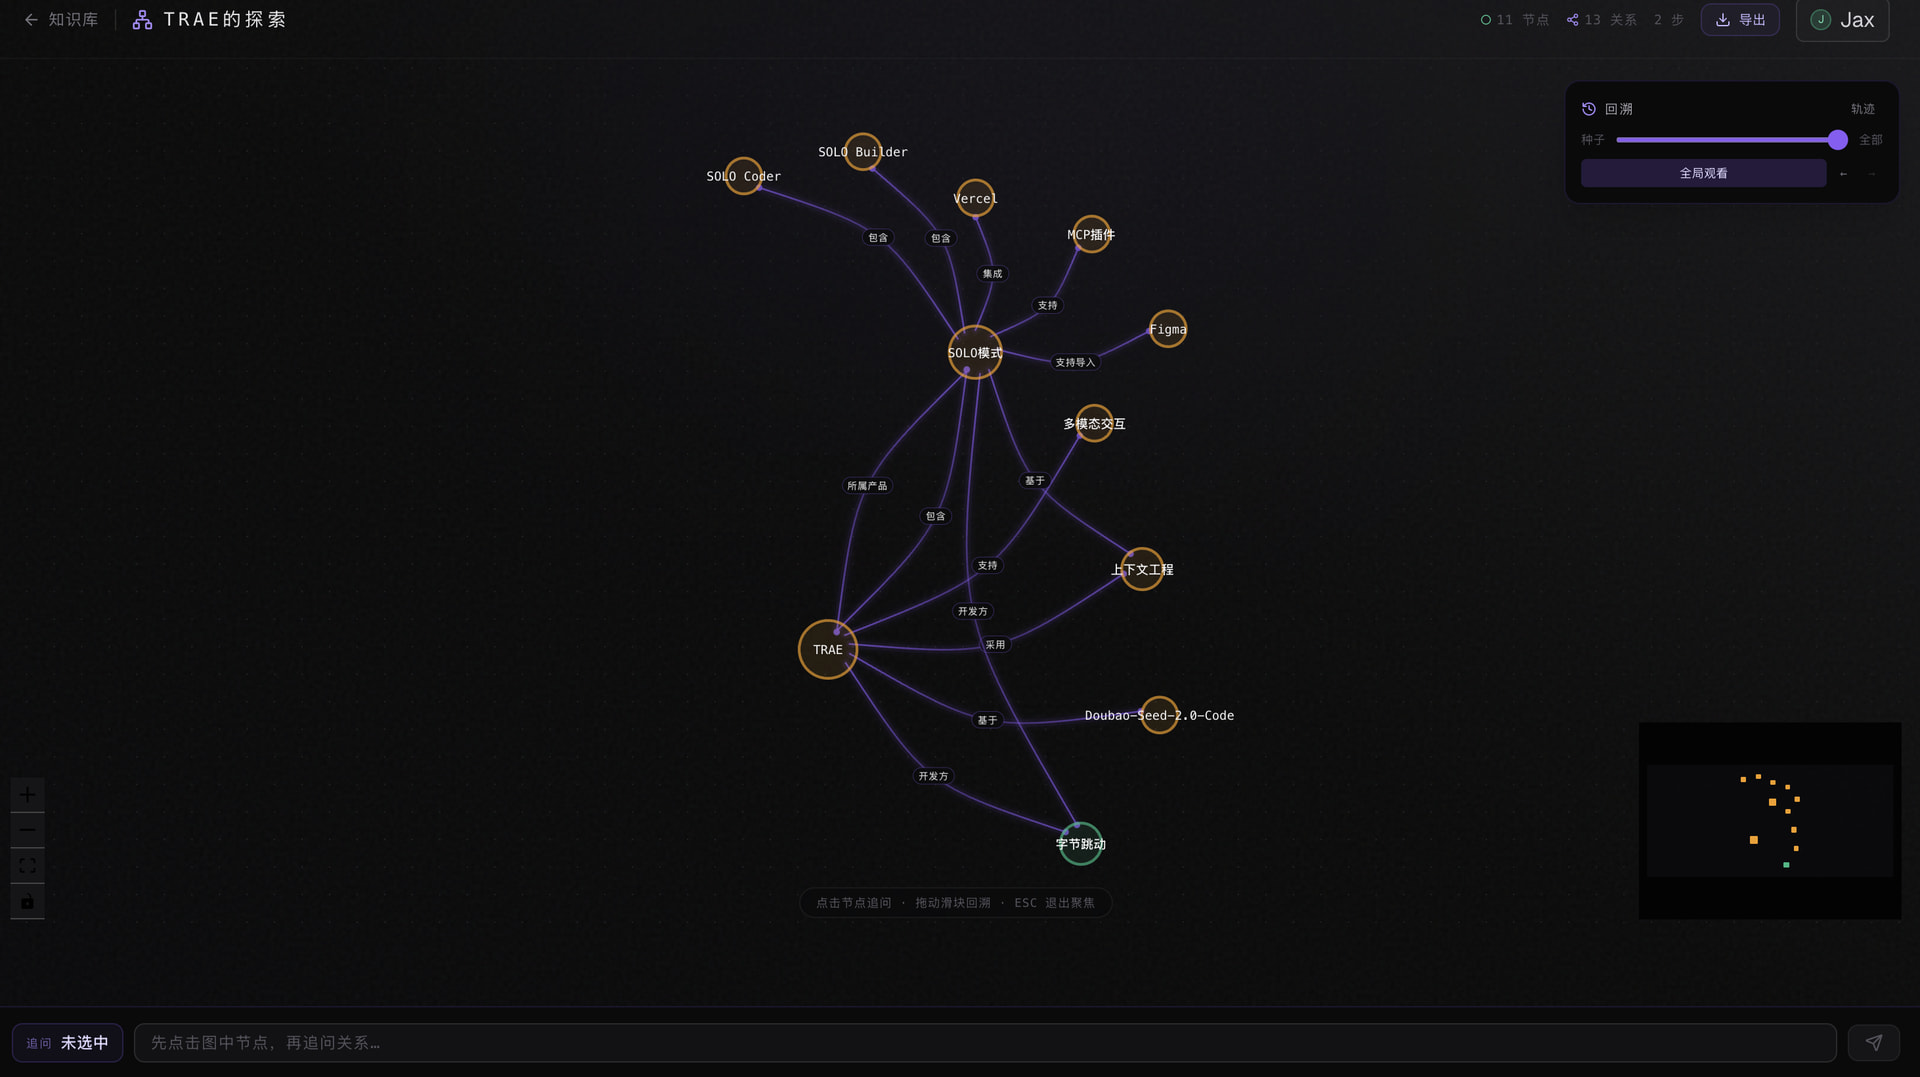
用户可以手动输入一个种子实体,也可以直接从总知识图谱选择节点发起探索。
选中任意节点并提出关系问题后,系统会:
- 规划探索方向;
- 联网检索相关证据;
- 抽取实体关系三元组;
- 将新节点和新关系实时加入图谱;
- 展示本轮回答摘要与来源。
用户可以沿新发现的节点继续追问,让图谱随着问题逐步生长;也可以使用回溯滑块查看不同阶段的图谱形态和问题轨迹。
探索完成后,可以:
- 重命名探索会话;
- 归档或恢复探索;
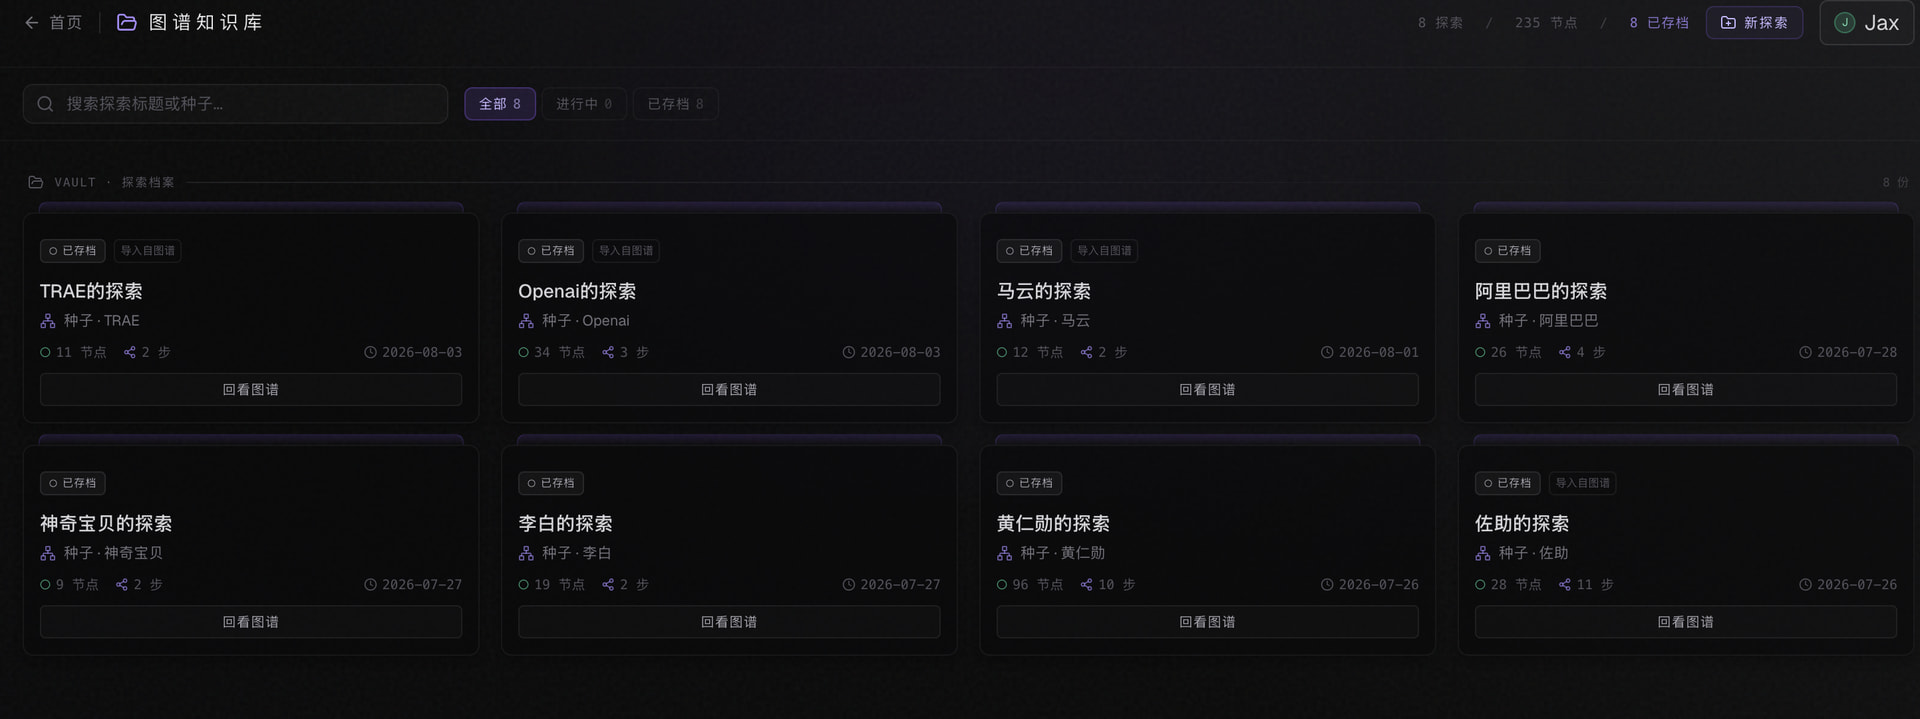
- 在图谱档案库中搜索和管理;
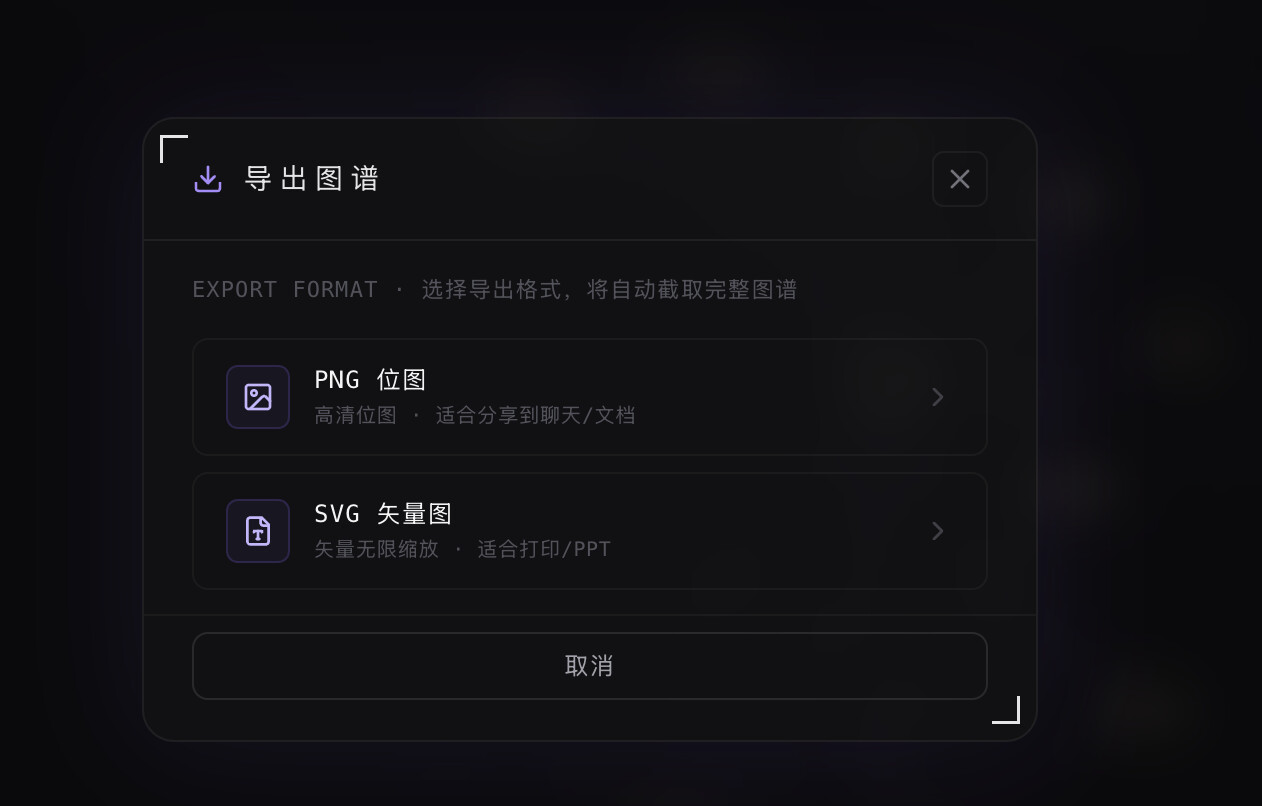
- 导出高清 PNG 或 SVG 图谱。
四、相比初赛 Demo,复赛版本升级了什么?
初赛 Demo 的重点是验证“看板即答案”:输入一个对象,生成六维情报卡片。
复赛版本则完成了五个关键升级:
1. 从单一搜索,升级为多信源研究
初赛主要依赖单一 Tavily 搜索;复赛加入可插拔多信源适配器、六维并行查询规划、RRF 融合、域名权威度和置信度计算。
2. 从一页 Demo,升级为七页面完整产品
产品现已覆盖首页、个人知识库、文件夹详情、专题图谱、总知识图谱、探索图谱和图谱档案库。
3. 从一次性回答,升级为个人知识资产
用户可以收藏卡片、建立文件夹、检索历史内容,并将收藏自动抽取为实体和关系。
4. 从静态关系展示,升级为可追问图谱
图谱不再只是查看结果。用户可以围绕任意节点提出问题,让新知识以节点和关系的方式加入图中,并回看完整探索过程。
5. 从视觉原型,升级为可部署的工程系统
复赛版本补充了账号认证、PostgreSQL 数据持久化、SSE 流式通信、搜索与结果缓存、风控、额度熔断和 Vercel 部署适配。
五、产品演示视频
https://v.douyin.com/qiJZFjmTVYg/
演示视频将完整展示:
六维研究 → 信源查看 → 卡片深挖
→ 收藏知识库 → 生成专题图谱
→ 从实体发起探索 → 图谱生长
→ 回溯、导出与归档
六、产品创作历程
这个项目的灵感,来自生活中一个非常真实的瞬间:
马上要讨论一个陌生话题、见一个重要的人,或者刷到一场看不懂的热点时,我们经常会想:“能不能让我在几分钟内真正弄懂它?”
传统搜索需要打开大量网页,自己筛选、拼接和整理;通用聊天工具虽然能总结,但输出常常是一大段纯文字,看不见完整脉络,也很难在之后继续使用。
因此,初赛阶段我选择了“不做另一个聊天机器人”,而是用六维可视化看板建立信息地图。
进入复赛后,我发现仅仅“把答案展示得更好”仍然不够。用户还会继续问:
- 这些信息来自哪里?
- 不同来源能否互相印证?
- 今天找到的内容,下次还能不能继续用?
- 不同人物、事件和公司之间究竟有什么联系?
- 如果沿着一个新发现继续追问,系统能不能记住探索过程?
这些问题最终推动了多信源研究、个人知识库和探索图谱三条产品主线。
其中最重要的技术决策,是把“收藏图谱”和“探索图谱”进行数据隔离:收藏图谱代表用户长期积累的知识大盘;探索图谱则代表一次明确方向的主动研究。这样既不会污染已有知识,又能让每一次探索保留完整轨迹。
七、TRAE 实践过程
我与 TRAE 的协作方式,不是一次给出一个巨型 Prompt,而是按产品阶段持续迭代:
明确问题与验收标准
→ TRAE 阅读现有代码
→ 拆解 TODO
→ 实现前后端功能
→ 类型检查与生产构建
→ 浏览器验证
→ 我反馈体验问题
→ TRAE 定位原因并继续修改
我的主要职责是产品定义、架构取舍、视觉方向、验收与迭代决策;TRAE 承担代码探索、方案比较、全栈实现、错误诊断和工程验证。
关键开发阶段
- 设计多信源研究与探索图谱 PRD;
- 建立 SourceAdapter、六维查询规划与 RRF 融合链路;
- 完成账号、知识库、文件夹与 PostgreSQL 数据迁移;
- 完成总图谱、专题图谱和动态探索图谱;
- 加入探索回溯、档案管理与 PNG/SVG 导出;
- 通过类型检查、生产构建、Mock 流程和在线环境持续验收。
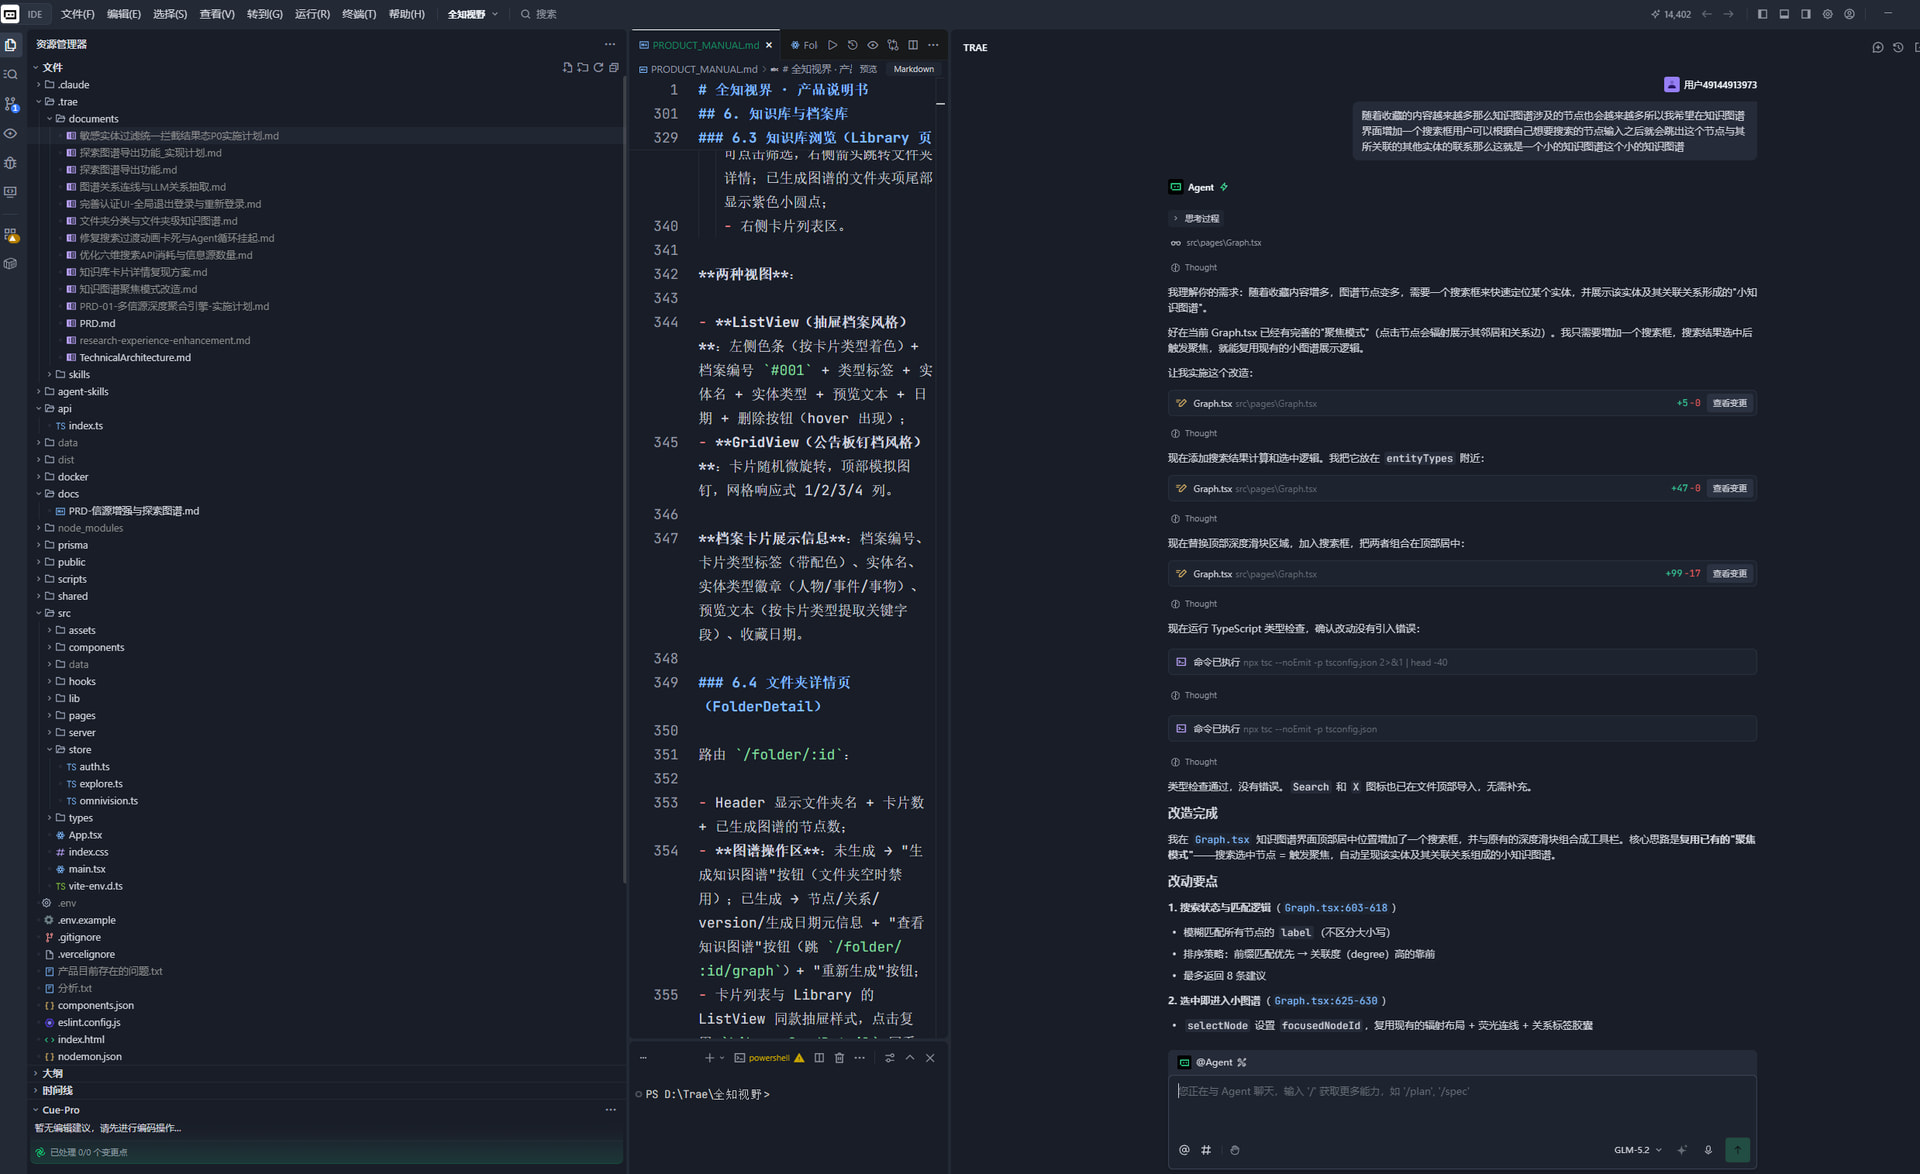
关键任务 Session ID
.913063551462068:bdaa5647ad95b42760d9bc67f29b3626_6a61e47dcb49c0f32c3aa23f.6a61e4bacb49c0f32c3aa259.6a61e4ba0df9860f3ef87c4d:Trae CN.T(2026/7/23 17:54:02)
.913063551462068:7194ab0804a420f69798a30df9f7862c_6a673201db8bcb415356bd68.6a6732addb8bcb415356bdb8.6a6732ad33d8aaa6628a2c89:Trae CN.T(2026/7/27 18:27:57)
.913063551462068:6fe0a74b56e6c1d213e0572c23b074bd_6a68a78333a5a8ade3961059.6a6d7706e7be1b32238c42c5.6a6d7706ed1a58128bf2c2ee:Trae CN.T(2026/8/1 12:33:10)
.913063551462068:0b97f44caa449bf6e333ddd60bc12206_6a68a78333a5a8ade3961059.6a6d652ae7be1b32238c41f0.6a6d652aed1a58128bf2c2ed:Trae CN.T(2026/8/1 11:16:58)
.913063551462068:b45575095ad96b487bb71185520a09f5_6a6de8d6f694483997014f0c.6a6dea46f694483997014f47.6a6dea46357ddb476017ac28:Trae CN.T(2026/8/1 20:44:54)
.913063551462068:99a720084a8baece03a486e221a603ba_6a61e5a0cb49c0f32c3aa287.6a66377270608629ec30dfe5.6a663772897ff7055eb5ecb3:Trae CN.T(2026/7/27 00:36:02)
八、技术方案
- 前端:React 18、TypeScript、Vite、Zustand、ReactFlow、Tailwind CSS;
- 后端:Express、Prisma、PostgreSQL / Supabase;
- AI 与检索:六维查询规划、多信源适配器、RRF 融合、去重、域名权威度和置信度计算;
- 实时交互:搜索、卡片深挖、追问和探索关系生成均采用 SSE;
- 数据系统:个人知识库、文件夹、实体关系、探索会话与步骤轨迹独立存储;
- 稳定性:多级缓存、单源失败降级、额度熔断、风险保护与结果快照;
- 部署:Vercel。
我认为 OmniVision 的技术价值不在于“调用了某一个大模型”,而在于如何把检索、证据、结构化表达、知识沉淀和持续探索组织成一套完整系统。
九、商业化与社会价值
短期:Web 端轻量化验证
采用 Freemium 分层模式,围绕热点人物拆解、事件全景复盘、竞品研究等高频场景验证用户需求。
依托“草台玩家 Jax”内容 IP,以及高校、创作者和 AI 工具社群完成首批用户冷启动,形成:
内容案例曝光 → 产品体验 → 用户反馈
→ 社群留存 → 产品迭代 → 口碑传播
中期:团队协作与软硬件延伸
面向高校课题组、小型研究工作室和自媒体团队推出协作版本,提供团队情报库、资料归档、专题模板和共享看板。
在不自研硬件的前提下,探索适配主流智能眼镜,让线下看到的人、事、物能够成为新的认知入口,实现“所见即探索”。
长期:个人认知图谱
让用户的查询、收藏、探索方向和思考习惯逐步沉淀为个人认知图谱。
产品将从“提供一次答案的工具”,成长为辅助用户记忆、关联和检索的数字认知助手。
OmniVision 的社会价值主张是:
降低形成可靠认知的门槛,帮助用户基于多源证据和多元视角独立判断。
不是替你看世界,而是帮你看见世界的更多面。
十、下一步迭代
- 完善账号权限、数据隐私和个人认知配置;
- 加强信源交叉验证、事实引用与 AI 幻觉修正;
- 提升首次研究速度和长任务稳定性;
- 让探索成果可选择性沉淀回知识库和总图谱;
- 增加团队协作、研究模板与共享能力;
- 探索与智能眼镜等硬件的标准化适配。
从初赛的六张卡片,到复赛的完整知识探索系统,我希望 OmniVision 最终做到的不是替用户思考,而是帮助每一个人更高效、更全面、更审慎地理解复杂世界。
感谢各位评委老师和社区朋友的阅读,也欢迎大家提出建议。