SDD并发多分支工作流的项目治理,积分要花掉才会有价值(bushi
Token(积分)的价值判断
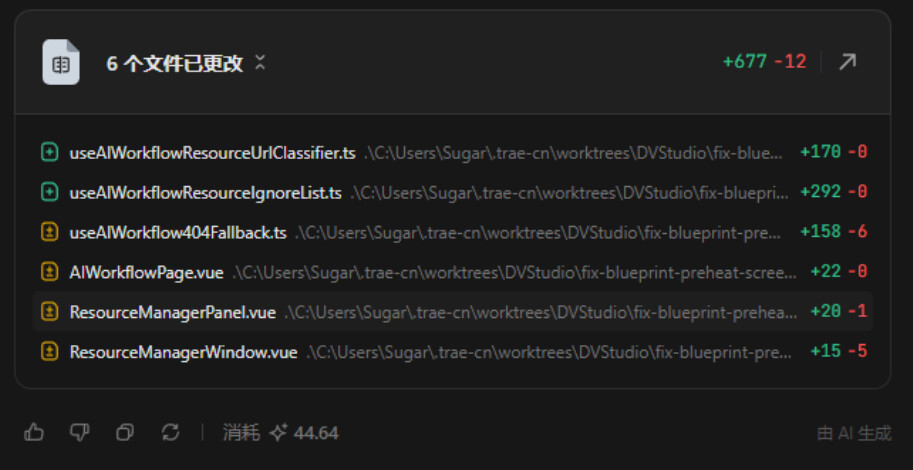
一次有效的任务标准在我们工作室的判断就是截图中的结果。
如果AI时代的开发没有办法保证代码的洁癖,那就要给出符合其Token扣量价值的代码行数变动,新增功能就是要增加行数,修改功能就是要增删都有,一切体现在代码行数。
任何事情一定要有量化的标准,才能体现价值。
既然需求是人类提的,那么对工程的进度推进标准就是代码行数与Commit数量的变化。
当然,代码行数多了并不代码功能实现,甚至可能只是多出了更多的Bug,那咋整。
所以下面是我这篇文章的核心观点:
项目架构的边界治理是Vibe Coding的核心价值,积分的消耗是对项目架构边界治理的量化体现。
推进度最快的方式一定是多分支并发,多分支的前提一定是项目架构边界治理的清晰。
积分要花出去才有价值,那么烧光它们最快的前提,也一定是架构边界足够清晰才行。
下面我先介绍一下我的项目与积分使用情况,然后再谈架构边界治理的经验。
一些需要对齐的共识
我认为这个讨论话题很有意义,特来参与活动分享自己的一些经验,希望和大家一起探讨。
为了更好的对齐一些积分价值讨论的共识,我先介绍一下我手边项目的一些背景。
我今年手边在开发的项目是一个技术美术相关的工作流软件
顺便提一下,这个项目咱报名TRAE的创造力大赛了: DVStudio AI时代的创作者的一站式资产管理与工作流编排工具。 - TRAE AI 创造力大赛 / 【大赛复赛专区】 - TRAE 官方中文社区
在这个项目中的Agent功能,集成了DeepSeek和DoubaoSeed,在项目实战中DoubaoSeed的多模态大模型在我自己的项目中表现并不比GPT差多少。
国内关于编码IDE工具方面,TRAE我也一直有关注。无缝兼容VScode生态属实是大赞,尤其是我们工作室自研的Vscode插件可以也在TRAE里面无缝迁移,很给力。
所以从6月开始我们工作室就将DVStudio的实际开发工作全面用TRAE来做了,整体使用下来比想象的更好。尤其是DoubaoSeed-2.1-Pro模型在TRAE中的表现。
当然,积分改制之后…用起来就有点贵了,不能一直无条件固定模型使用了。
所以关于积分的节流利用,如何体现价值,我想从几个方面来谈谈我的看法。
我的最近7天的积分使用情况
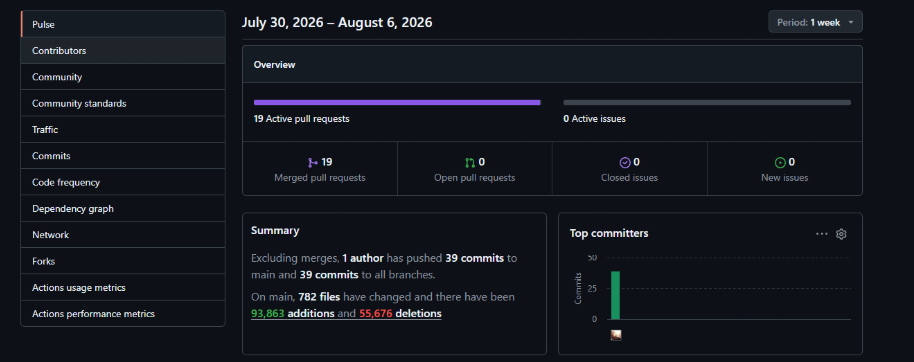
最近7天的代码仓库更新数据:700+文件更改,39个Commit,9万行新增,5万行删除,整体代码量大约在20万行左右。
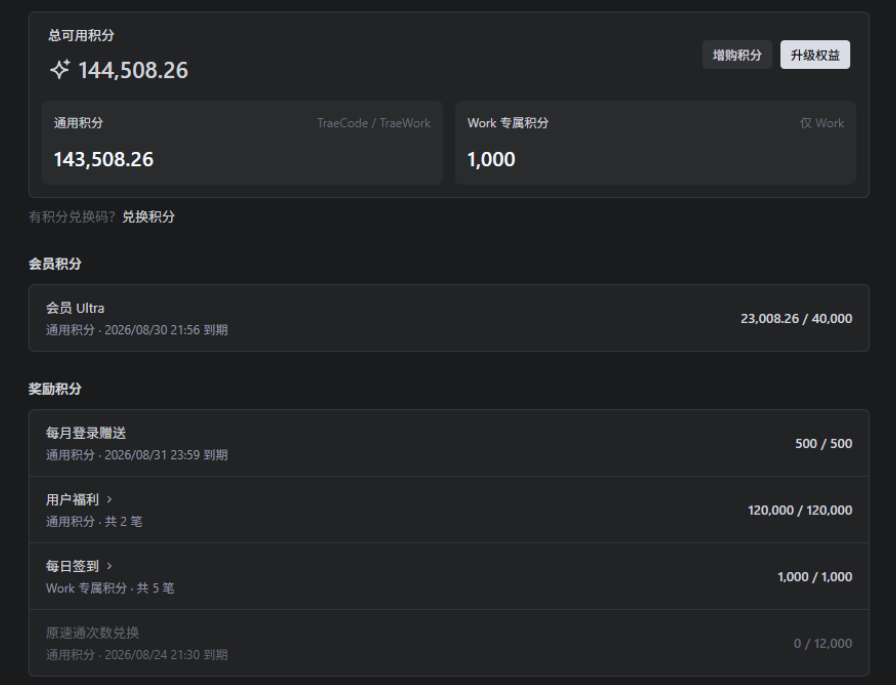
这是我从积分改制8月1日到现在的积分使用情况。一周下来,积分消耗了大约1.7万左右。其实按我的强度来说,这个消耗量还算合理。
一周1万,尊贵的Ultra会有一个月4万,嗯,合理。(所以特来参与活动,求社区支援)
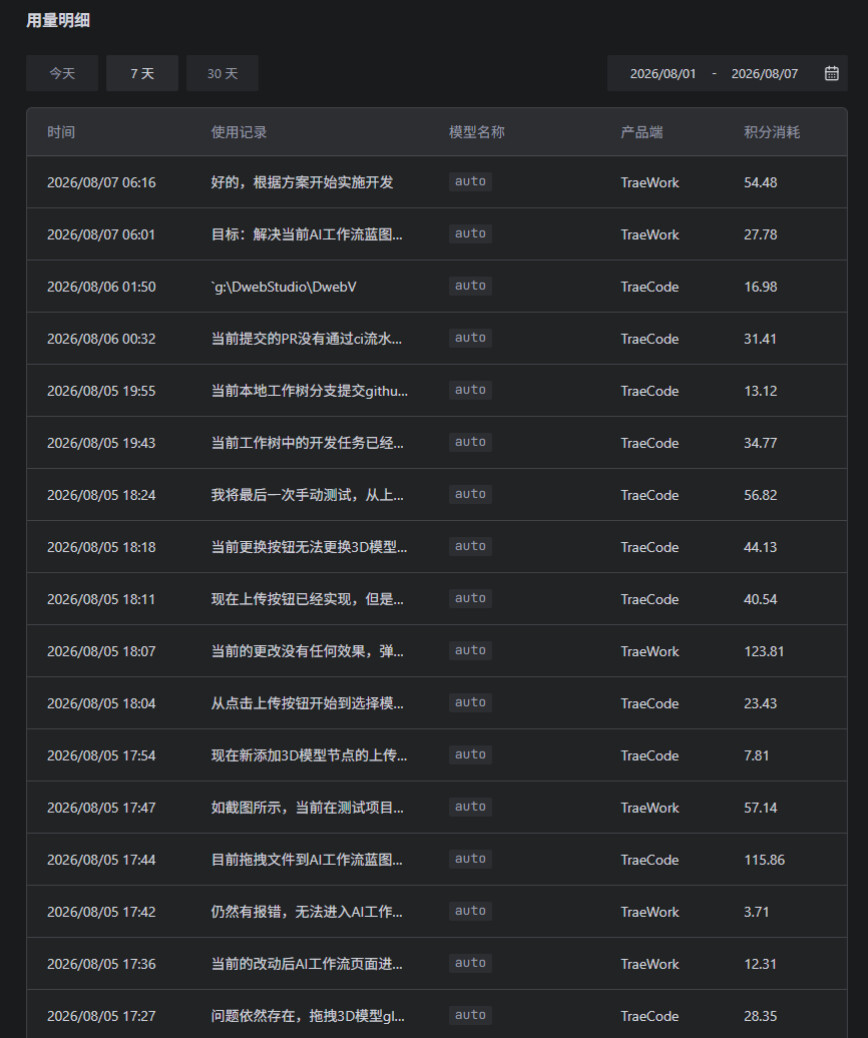
这是我平均单任务的消耗情况,可以看得出来,从积分改制之后,我只用auto模型,平均每个任务大概就是几十到几百积分的消耗。
如果便宜的模型就能办事,疯了要一直烧贵的?
项目架构边界治理的经验
既然我们要谈架构,首先的前提是开发者本人要对当前使用的编程技术栈有足够的熟悉度,才能对项目架构边界治理有一个清晰的认知。
也就是说,人类自己得先会,才能对AI生成的代码有清晰的判断。人会的越多,对AI控制的就越精准。那么积分自然就花得更有价值。
那这里就有一个悖论:“我就是因为不会才想用AI帮我实现,咋整”
所以问题就变成了,AI时代下人人都是架构师,那么如何速成架构师就是重中之重。
Vibe Coding架构师速成分如下三步:
-
文件夹结构就是架构边界治理的第一步。
根据需求的功能模块划分文件夹结构,这一点AI直接就可以帮你实现,甚至可以帮你生成一个初步的文件夹结构。
-
项目根目录下的Agent文档是架构边界治理的第二步。
这个文档需要让AI先规划完文件夹结构之后,生成一个Agent文档,里面包含每个文件夹的功能说明,以及每个文件夹下的主要文件的功能说明。
让每一次Agent会话都能读取这个文档,作为对每一个单独任务的功能边界约束。这样就可以让AI在每一次会话中都能遵循这个边界约束,避免出现越界的代码生成。
-
每一个任务一次会话的铁则
既然已经划分的边界,那么每次会话都要遵守。越界的任务不要出现在同一轮会话中。这是铁则。别没事跟AI聊有的没的。不满意就重开分支开新会话,少废话。
Git仓治理+CI流水线做回归测试验证
如果不明白什么是回归测试,那么就需要让AI先帮你做项目的测试覆盖率分析。
Git仓治理与CI流水线的回归测试验证是Vibe Coding的质量的唯一保障。没有回归测试的项目治理是没有价值的。
就好像人类要测试功能是否实现,就要去点一点看是否实现了功能一样,AI也需要有一个回归测试的验证机制,来判断它生成的代码是否符合预期。
人类的人机交互就算功能实现了,也不代表AI生成的代码就没有Bug。
人类的交互是黑盒测试,是不能算数的。
只有通过CI流水线的回归测试验证,才能算半次任务的进度推进。
另外半次是合并代码后的人机交互验证。所以每一次的任务推进都需要两次验证,才能算是有效的任务推进。
即便是这样,其实也没办法保证AI生成的代码没有Bug。那么就需要在AI写代码的过程中具备一套可验证的日志机制,来辅助在单次会话中开发的循环迭代。
日志系统辅助每一次任务真正的推进
AI写代码全靠日志系统提供的反馈才能真正的推进任务。
没有日志反馈验证的代码,全是AI盲猜乱写的。
每一次任务中,AI写完代码,尤其是前端,一定要有对应的日志反馈给AI去判断输出是否符合预期,否则就算是AI写完了代码,也不代表任务推进了。
这一点就是经常会遇到的情况,写完这里,那边又出Bug了,或者是功能实现了,但是UI交互体验不符合预期。这就是没有日志反馈的结果。
结语
最后总结一下的话,就是AI时代,不要害怕AI写代码,更不要害怕删代码重构。
当实现一个功能变得不再有门槛,那么可持续的迭代,可持续的重构,才是AI时代下的开发者的应该具备的能力。
最重要的是代码行数越少,代表你的防护越低。AI写代码,代码成本并不高。谁能一直迭代,谁的项目才是有价值的。
平均一段实际业务函数代码,要搭配几十行的测试代码,才能保证功能的稳定性。十几行日志代码,才能保证功能的可追踪性。
既然AI时代人人都可以写,那么谁能一直写,谁就能一直迭代,谁的项目才是有价值的。