让 AI 连续打工 16 小时不崩溃?我总结了 13 条大项目“驯服”铁律》
从 6GB 跨语言迁移实战中提炼的 TRAE AI 调度法则,把 AI 从“代码民工”变成“全自动工程团队”)
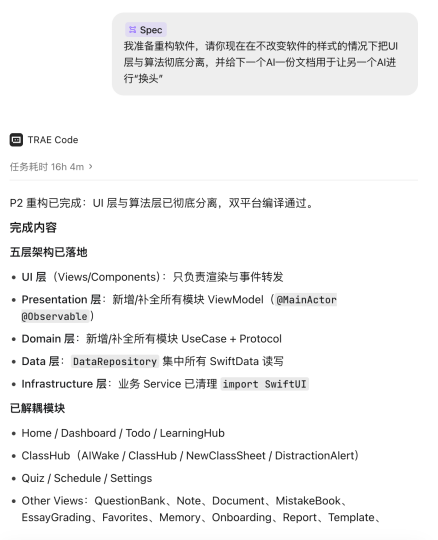
 一句话推荐
一套为TRAE专门定制,经过 6 小时实战验证的 AI 大项目管理规则,让 TRAE AI 从"写代码的工具"变成"能独立交付的工程团队"。(为了这个,我专门逆向了TRAE的斜杠命令(狗头饶命))
 这套规则解决什么问题?
| 痛点 | 传统 AI 编程 | 使用本规则后 |
|---|---|---|
| 长任务崩溃 | 最多 1.5 小时就跑偏 | 稳定运行 6 小时+ |
| 上下文爆炸 | 规则冗长、token 浪费 | 精炼指令,留出更多空间给代码 |
| 项目失控 | AI 一锅炖,改东墙塌西墙 | P0→P1→P2 分阶段闸门,逐步交付 |
| 方案 ≠ 代码 | AI 写完方案就开始乱写代码 | 方案审批与编码授权严格分离 |
| 平台绑定 | 只能在特定工具中使用 | 可迁移至 Cursor / Claude Code 等任意平台 |
 规则架构一览
┌─────────────────────────────────────────────────┐
│              🧠 主 AI 代理(调度层)               │
│   只负责拆解、委派、审批,不写实现代码                │
└──────────┬──────────┬──────────┬────────────────┘
           │          │          │
     ┌─────▼───┐ ┌────▼────┐ ┌──▼──────┐
     │ UI 子代理│ │逻辑子代理│ │数据子代理│  ← 分片并行
     └─────────┘ └─────────┘ └─────────┘
           │          │          │
     ┌─────▼──────────▼──────────▼────────────────┐
     │           🔍 审查子代理(实时质检)            │
     └────────────────────────────────────────────┘
十条核心规则速览
| # | 规则名称 | 核心要点 |
|---|---|---|
| 1 | 调度分工 | 主代理只拆解不写码,除非子代理连续失败 2 次 |
| 2 | 分片并行 | UI / 逻辑 / 数据层独立并行,≥3 子代理同时开发 |
| 3 | 文档阅读 | 优先用浏览器读文档,失败降级 WebFetch |
| 4 | 新功能检查 | 异常处理 → UI 自查 → 功能完整性,三步必过 |
| 5 | 需求澄清 | 不确定就问,绝不猜测,不结束对话 |
| 6 | 质量优先 | 禁止跳过任何检查步骤 |
| 7 | 分优先级 Spec | P0 通过 → P1 → P2,每阶段生成 spec/tasks/checklist |
| 8 | 编码授权边界 | 方案获批 ≠ 可以写码,需用户明确授权 |
| 9 | 编译验证 | 每个优先级结束时必须整体编译,通过后才能进入下一阶段 |
| 10 | 豁免隔离 | 用户可豁免某条规则,但仅限当前回合,技术债务必须声明 |
别复制这里的,规则在下面 (Step 1:复制规则)
 七大核心优势
 通用性极强 — 不绑定任何项目
跨语言迁移、大型重构、从零搭建、架构升级……只要任务规模大、周期长、结构复杂,这套规则就能适配。
 驯服长周期任务 — 实战验证 6 小时稳定运行
通过 分阶段闸门(P0/P1/P2)+ 编译验证 + 方案执行分离,让 AI 在一次会话中完成以前根本不可能完成的跨语言、跨生态迁移。
 轻量化 — 节省上下文空间
每条规则直接对应一个执行动作,没有冗余解释。相比动辄几千 token 的 AI 技能描述,这套规则极其精炼,为实际代码和调试留出充足空间。
 可移植性强 — 不被平台锁死
规则描述的是工作流结构,不依赖 Trae 特有 API。迁移到 Cursor、Claude Code 等平台只需调整少量工具映射。
 可迭代、可优化
规则是活的——随时修改,下一轮对话立即生效。已在实战中补上"或更多优先级"和"永动循环"等补丁,随经验持续进化。
 有明确可验证的成功案例
6GB Swift 工程 → 跨语言迁移 → 独立软件成功嵌入并正常启动 → 6 小时、几轮调试、一次会话完成。不是"理论可行",是事实可行。
 使用方式
Step 1:复制规则
将下方规则文本完整复制到你的 AI 编辑器自定义规则中:
在制作大项目(重构、从零开始制作)时你需要遵守的规则(小改动如修bug、加功能等请忽略):
一、调度分工:主AI代理(即你)只负责拆解调度与任务委派,不写实现代码。仅同一子代理同一任务连续失败 2 次,或改动核心基类(被 ≥3 个模块依赖的基础类)时,本体才可介入。
二、分片并行(在plan模式下请忽略):按 UI / 逻辑 / 数据层切分,相互无依赖时可同时拉起 ≥3 个子代理并行开发;存在依赖关系时按依赖顺序串行。另起 1 个审查子代理实时检查(代码风格、符合 spec、有无 bug)。
三、文档阅读:用户给链接时,优先用 agent-browser 读;失败则用 WebFetch 并附来源。
四、新功能检查:① 异常处理 ② UI 自查(圆角/色值/悬停/适配/与原风格匹配)③ 功能完整性。
五、需求澄清:需求不明确必须用 AskUserQuestion,不得猜测,不要结束对话;技术细节自行查文档。
六、质量优先:禁止跳过任何检查步骤。
七、分优先级 spec(在plan模式下请忽略):任务有 P0/P1/P2(或更多)时,依次撰写,前一个优先级(如P0)全部通过后才写下一个(如P1)(如果有下一个优先级,自动进入下一个优先级,禁止结束对话),生成 spec.md / tasks.md / checklist.md,完成后都必须 NotifyUser 审批。每个 spec、task 、TODOlist末尾必须写触发下一阶段的指令用来**自动**进入下一优先级。“全部通过”指:在本优先级下,spec 获批 + tasks 全部完成 + checklist 全部勾选 + 规则九编译验证通过。(一轮对话中要完成所有内容(所有P))
八、编码授权边界:用户先说“不要写代码/只写方案”并开启 spec/plan 模式的,NotifyUser 批准方案 ≠ 编码授权,AI 立即停止等下一步(停止对话)。下一轮用户明确说“开始写代码/可以编码”才算正式授权,且仍遵循规则七的优先级流程。
九、编译验证:每个优先级阶段(P0/P1/P2)结束时,须整体编译验证,确认无误后再进入下一优先级。(若项目仅有单个优先级,则在最终交付前编译验证一次即可。)
十、豁免隔离:用户须明确引用条例编号并说明可违反,该豁免才在当前对话回合生效,且不继承至下一轮或任何子代理。若豁免产生技术债务,AI需在交付时声明。
十一、请求调试:如果遇到难以解决的问题,你可以申请让我(使用AskUserQuestion询问我)运行相应的程序并给你调试信息(注意,调试信息.txt在你没有询问用户之前可能不是最新的(除非用户主动提及。(如:你可以查看 调试信息.txt) ))
十二、方案审查:如果用户拒绝了这个方案,禁止停止对话,你需要询问用户原因并重新做一份;如果批准了方案,参考规则七、八、九。
十三、单次并行子代理调用的上限是 15个。一般在运行查找信息等需要大量数据又可以并行处理的场景下使用(例如:批量网页搜索、多文档并发分析或跨平台数据聚合)。
Step 2:开启 Plan / Spec 模式
告诉 AI 你的项目需求,它会:
- 自动生成 spec.md(规格说明)
- 拆分 tasks.md(任务清单)
- 生成 checklist.md(验收检查表)
-
- 再次进行这一步骤直到所有内容全部完成(有效解决了AI做事情 不分主次 的问题)
(建议选择比较靠前一点的模型)
- 再次进行这一步骤直到所有内容全部完成(有效解决了AI做事情 不分主次 的问题)
Step 3:审批 → 授权编码 → 交付
审批方案 → 明确说"开始写代码" → AI 按优先级逐步交付 → 编译验证 → 进入下一阶段
 我是怎么做的
一个字,逆向!我通过逆向TRAE的spec文件和plan文件了解了他的内置的skill,从而让我的规则提示的更精准(饶命);同时,我使用了AI帮我在不改变原意的方式压缩长度,减少上下文
 效果对比
| 指标 | 使用前 | 使用后 |
|---|---|---|
| 单次会话最长稳定时间 | ~1.5 小时 | 6 小时+ |
| 任务跑偏率 | 高(中后期失控) | 极低(闸门机制兜底) |
| 上下文消耗 | 大量浪费在冗余输出 | 精炼高效 |
| 交付可控性 | 不可预期 | 每阶段可验证 |
| 跨平台迁移成本 | 需重写 | 仅调整工具映射 |
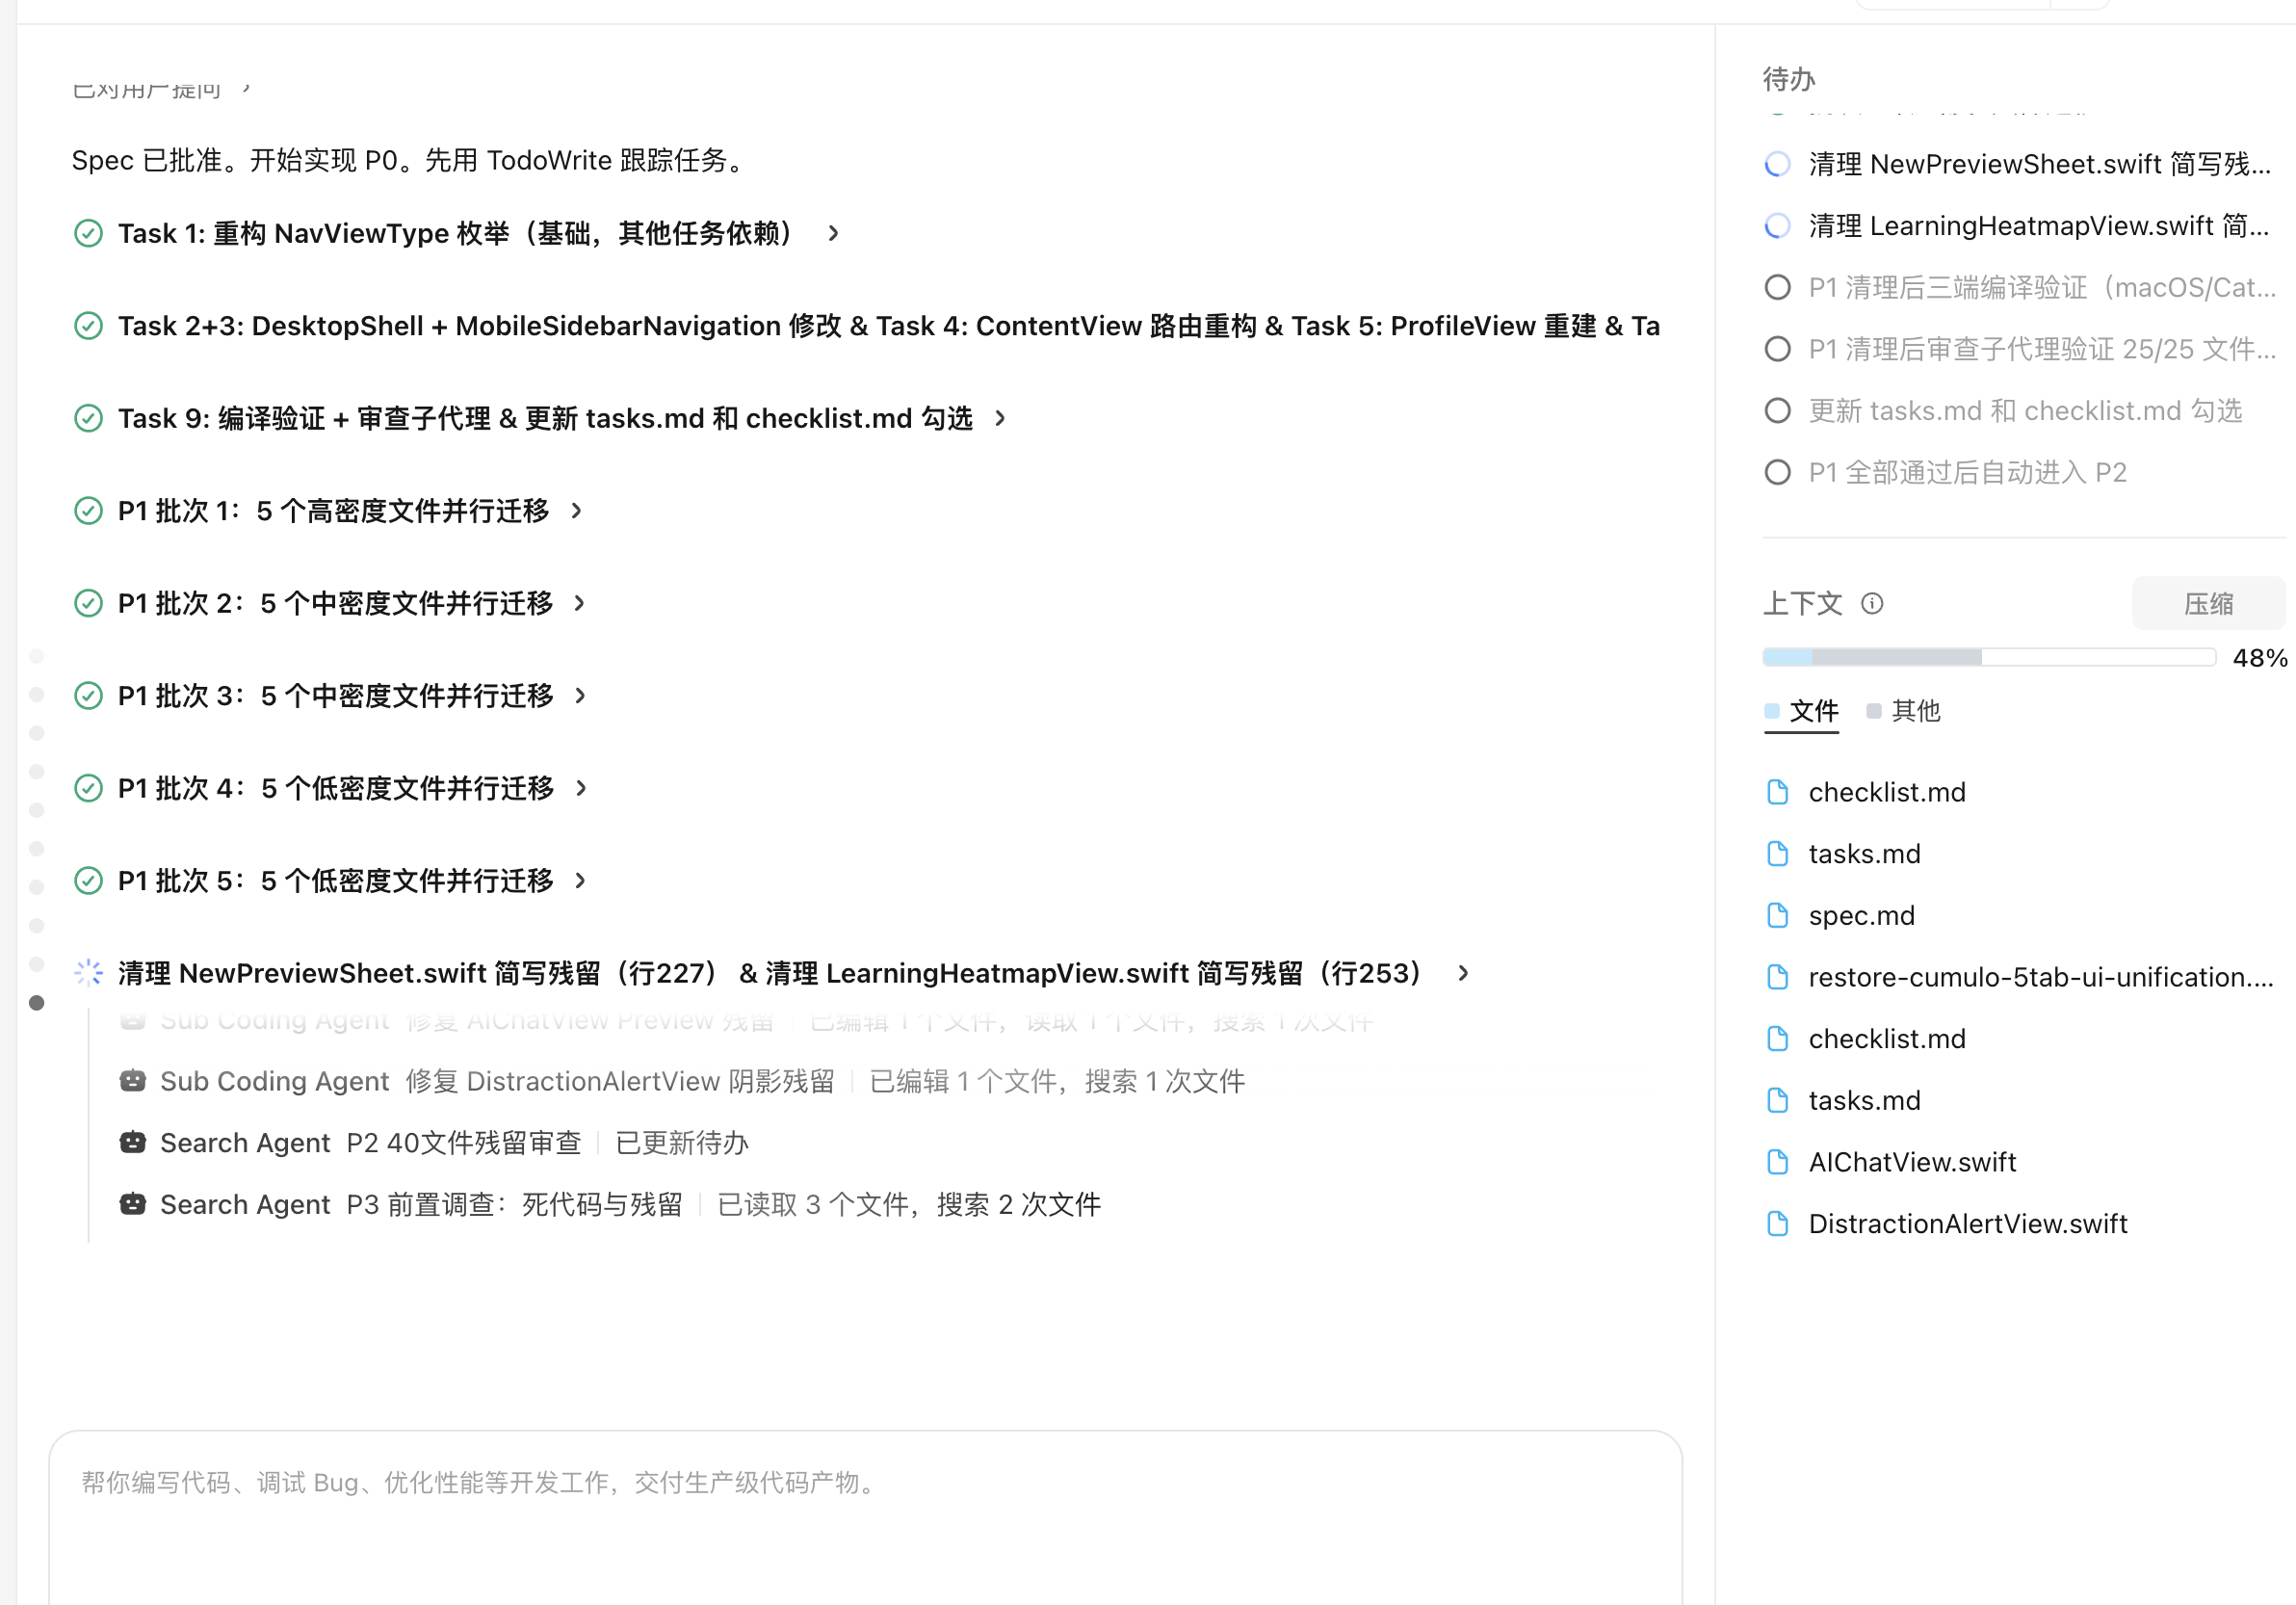
可以看到,一个大任务被分成了P0,P1,P2,一个P可以分成不同的批次。AI可以慢慢忙
本规则体系已通过 6GB Swift 工程跨语言迁移实战验证。规则可自由复制、修改、传播,你需要遵守 MIT协议。
(旧的规则有12条,你可以在这里下载规则.md.zip (2.3 KB))
喜欢就点个赞吧
