用 TRAE 三模式造一个视障导航产品:LightPath 光径从想法到上线的全流程复盘 
参加 TRAE 创造力大赛时,我想做一个面向视障者的 AI 语音导航网站——LightPath 光径,聚焦"最后 20 米"出行场景:地图把你带到目的地附近,但入口在哪、盲道有没有被占、前方是不是台阶,这些信息缺口直接影响一个人能否独立完成就医、办事。
这篇文章不讲理论,只讲我怎样用 TRAE 的 Work → Design → Code 三个模式,把这个想法变成一个已部署上线、可体验的真实产品。
参赛帖:LightPath 光径|为视障者点亮最后 20 米的 AI 语音导航
在线体验:lightpath-bay.vercel.app
一、Work 模式:把模糊想法变成产品方案 
痛点不是"视障者需要导航",而是"导航结束后的那 20 米"
最初我只有一个模糊想法:“做个帮视障者导航的产品”。如果直接开始写代码,大概率会做成一个低配版百度地图——什么都有,什么都不精。
在 Work 模式里,我没有急着让 AI 写代码,而是先让它帮我做产品边界推演:
"我要做一个面向视障者的语音导航 Web 应用。请帮我分析:
- 地图导航已经解决了什么,还有什么没解决?
- 如果聚焦’最后 20 米’,目标用户具体是谁?
- MVP 应该包含哪些功能,不应该包含哪些?
- 用什么技术栈最合适?"
Work 模式帮我锁定了三个关键决策:
决策 1:不做完整地图导航,只做最后 20 米。 地图导航已经有很多成熟产品,但"到了附近却找不到入口"这个缝隙没人补。LightPath 只补这 20 米。
决策 2:语音优先,界面辅助。 视障用户的核心信息通道是听觉,不是视觉。所有关键信息必须能被"听懂",界面文字只是给陪行人员或低视力用户看的辅助。
决策 3:方位口语化。 不用"北偏东 30 度"这种抽象表达,而是"1 点钟方向,约 4 米"——这是视障导盲训练中实际使用的方位语言。
从产品方案到数据模型
边界确定后,Work 模式继续帮我设计数据结构。10 张表,覆盖用户、场景、路线、识别项、风险、导航记录、反馈、问题、贡献全链路:
// 核心数据模型(简化版)
model User {
  id             String   @id @default(cuid())
  email          String   @unique
  passwordHash   String
  role           Role     @default(user)    // 普通用户 / 管理员
  feedbackCount  Int      @default(0)       // 反馈计数
  navigationRecords NavigationRecord[]
  feedbacks      Feedback[]
  contributions  Contribution[]
}

model Scene {
  id          String   @id @default(cuid())
  slug        String   @unique             // hospital-outpatient
  name        String                       // 地铁口到医院门诊楼
  category    SceneCategory                 // medical/community/mall/school
  status      SceneStatus  @default(published)
  segments    Segment[]                     // 路线步骤
  detections  Detection[]                   // AI识别项
  risks       Risk[]                        // 风险提醒
}

model NavigationRecord {
  id      String   @id @default(cuid())
  userId  String
  sceneId String
  status  NavigationStatus @default(ongoing) // ongoing/arrived/abandoned
}

model Feedback {
  id          String   @id @default(cuid())
  userId      String
  category    FeedbackCategory               // blind_path_blocked/no_ramp/...
  comment     String?
}
Work 模式的价值:不是替你做决定,而是逼你想清楚。当我把"最后 20 米"这个边界确定后,后面的 Design 和 Code 每一步都有明确方向,不会跑偏。
二、Design 模式:让产品"看得见、摸得着" 
从单文件 HTML 到完整 UI 系统
LightPath 最初版本是一个单文件 HTML,能展示交互流程但没有设计体系。进入 Design 模式后,我需要解决三个设计问题:
问题 1:暗色主题还是亮色主题?
视障用户中有大量低视力用户,对强光敏感。我选择了深色主题——深蓝黑底色 + 琥珀金强调色,既降低光刺激,又保证高对比度。
问题 2:导航模拟器怎么设计?
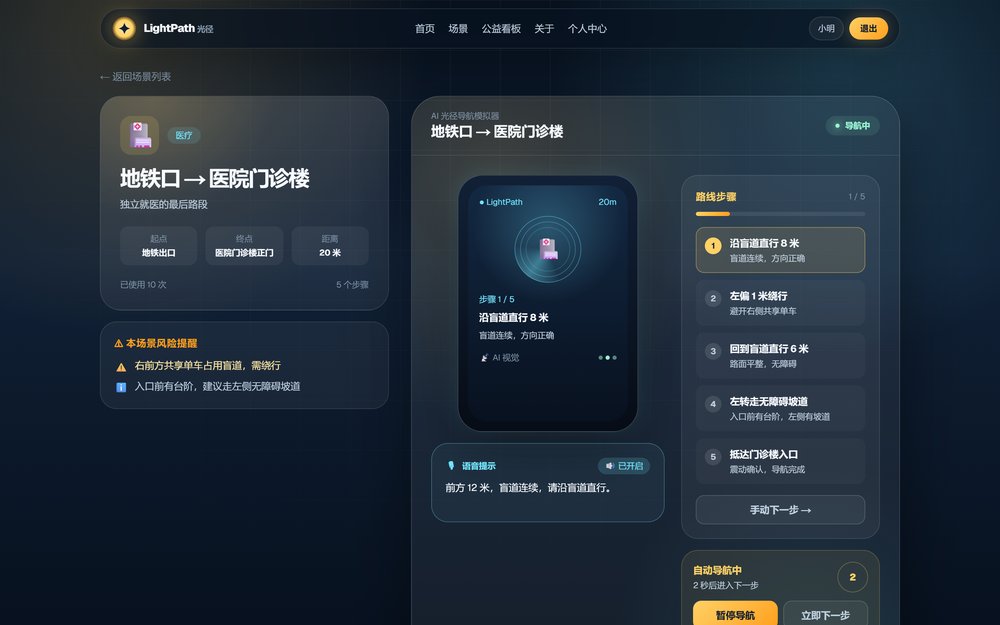
用户选场景 → AI 扫描环境 → 语音导航自动推进 → 到达后提交反馈。这个流程需要一个清晰的两栏布局:左边选场景,右边展示导航过程。
问题 3:信息层级怎么排?
导航过程中有大量信息(盲道方向、障碍物、入口位置、台阶坡道),不能一股脑全抛给用户。我用了渐进式披露:先展示当前步骤,风险提醒用独立卡片高亮,详细信息可展开。
Design 模式产出的核心组件架构
Design 模式帮我拆分了导航模拟器的组件结构:
NavSimulator(状态机:待命 → 扫描中 → 导航中 → 暂停 → 已抵达)
├── ScanProgress       AI 扫描进度
├── VoicePrompt        语音播报(Web Speech API)
├── RouteSteps         路线步骤列表(当前步高亮)
├── RiskAlerts         风险提醒卡片
└── ArrivalFeedback    到达反馈表单
这个拆分让每个组件职责单一,后面 Code 模式实现时可以逐个开发、逐个测试。
设计成果
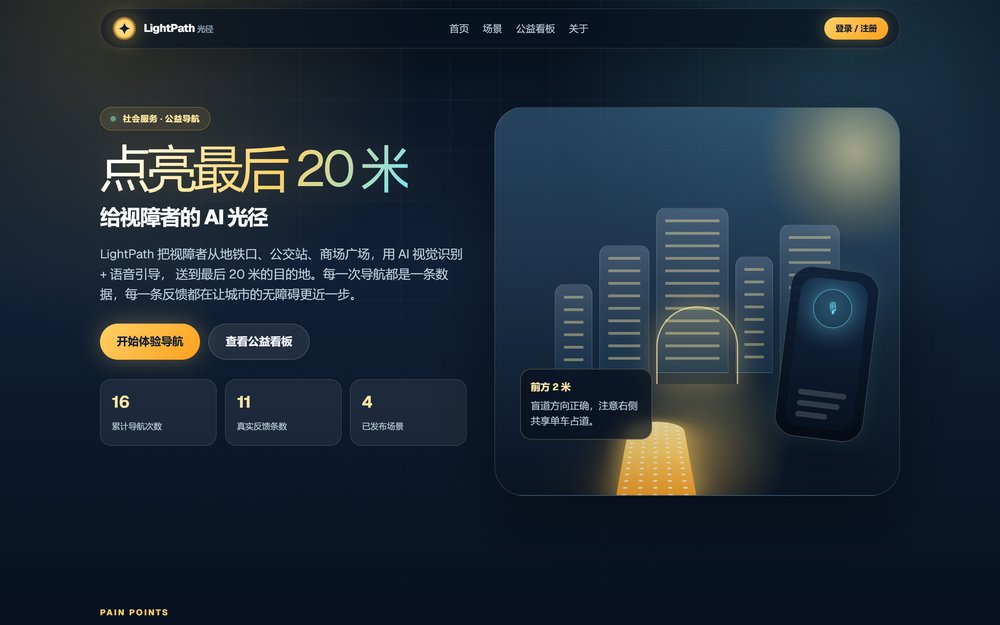
最终产品首页是一个深色主题的着陆页,核心区域是"最后 20 米导航模拟器":
- 四张场景卡片:地铁口→医院、公交站→社区中心、商场→无障碍入口、校门口→办事大厅
- 导航面板:深色可视化区域 + AI 识别卡片 + 语音提示 + 步骤指引
- 公益看板:反馈数据共建,每次反馈都让城市更美好
三、Code 模式:从设计到可部署的产品 
三层架构:Repository → Service → Server Actions
Code 模式中,我让 TRAE 按照三层分离架构生成代码:
actions/       → Server Actions(调用 service,返回给前端)
services/      → 业务逻辑(调用 repository,处理事务)
repositories/  → 数据访问(调用 prisma,只管 CRUD)
这种分层让代码职责清晰:换数据库只改 repository,换业务逻辑只改 service,换前端交互只改 actions。
核心实现 1:自动导航状态机
导航的核心是"自动推进"——每一步倒计时结束后自动进入下一步,也可以暂停、继续、立即跳转。我用一个纯函数管理状态转换:
// autoNavigation.ts
export type AutoNavigationResult =
  | { type: "next"; step: number }
  | { type: "arrived" };

export function getNextAutoNavigationState({
  currentStep,
  totalSteps,
}: {
  currentStep: number;
  totalSteps: number;
}): AutoNavigationResult {
  const next = currentStep + 1;
  if (next >= totalSteps) return { type: "arrived" };
  return { type: "next", step: next };
}
先写纯函数测试,验证状态转换逻辑正确,再把它接入 React 组件。这就是 TDD 的思路——先验证逻辑,再接入 UI。
核心实现 2:反馈提交事务
用户到达目的地后提交反馈,需要同时操作四张表:写 feedback、更新 navigation_records 状态、写 contributions 贡献记录、给 user 计数加一。四个操作必须在一个事务里,要么全成功,要么全回滚:
// feedback.service.ts(简化版)
async submitFeedback({ navigationRecordId, userId, category, comment }) {
  return await prisma.$transaction(async (tx) => {
    // 1. 写反馈记录
    const feedback = await tx.feedback.create({
      data: { navigationRecordId, userId, category, comment },
    });
    // 2. 更新导航记录状态
    await tx.navigationRecord.update({
      where: { id: navigationRecordId },
      data: { status: "arrived" },
    });
    // 3. 写贡献记录(积分+2)
    await tx.contribution.create({
      data: { userId, points: 2, type: "feedback" },
    });
    // 4. 用户反馈计数+1
    await tx.user.update({
      where: { id: userId },
      data: { feedbackCount: { increment: 1 } },
    });
    return feedback;
  });
}
核心实现 3:AI 识别降级策略
AI 场景识别接口设计了降级机制——有 API Key 时调真实 AI,没有时降级为数据库预置结果,保证 Demo 在任何环境下都不白屏:
// ai.ts(简化版)
export async function recognizeScene(imageBase64: string, sceneId: string) {
  const apiKey = process.env.OPENAI_API_KEY;
  if (!apiKey) {
    return getMockRecognition(sceneId);  // 降级:返回预置结果
  }
  try {
    const result = await callAI(imageBase64);
    return { ...result, source: "ai" };  // 真实AI结果
  } catch {
    return getMockRecognition(sceneId);   // 失败也降级
  }
}
核心实现 4:语音播报
语音播报用浏览器原生 Web Speech API,不依赖任何第三方 TTS 服务:
// VoicePrompt 组件核心逻辑
function speak(text: string) {
  if (!("speechSynthesis" in window)) return;
  window.speechSynthesis.cancel();  // 先取消正在播报的
  const utterance = new SpeechSynthesisUtterance(text);
  utterance.lang = "zh-CN";
  utterance.rate = 0.9;  // 稍慢,适合视障用户
  window.speechSynthesis.speak(utterance);
}
测试覆盖
Code 模式还帮我写了 10 个测试文件,覆盖核心业务逻辑:
// feedback.service.test.ts
describe("feedbackService.submitFeedback", () => {
  it("提交反馈:建反馈 + 用户计数+1 + 写贡献", async () => {
    const user = await authService.register({ email, password, name });
    const scene = await findSeedScene("hospital-outpatient");
    const navResult = await navigationService.startNavigation({
      userId: user.id, sceneId: scene.id,
    });

    const feedback = await feedbackService.submitFeedback({
      navigationRecordId: navResult.id,
      userId: user.id,
      category: "blind_path_blocked",
    });

    expect(feedback.categoryLabel).toBe("盲道被占用");
    // 验证用户计数+1
    const updatedUser = await prisma.user.findUnique({ where: { id: user.id } });
    expect(updatedUser?.feedbackCount).toBe(beforeCount + 1);
    // 验证贡献积分
    expect(after - before).toBeGreaterThanOrEqual(2);
  });

  it("导航记录不存在时抛错", async () => {
    await expect(
      feedbackService.submitFeedback({
        navigationRecordId: "non-existent-id", userId: null,
      })
    ).rejects.toThrow("导航记录不存在");
  });
});
三模式协作全景图 
回头看,LightPath 的开发过程就是三模式的接力:
| 阶段 | 模式 | 做了什么 | 产出 |
|---|---|---|---|
| 1. 产品定义 | Work | 确定边界、用户、MVP功能 | 产品方案 + 数据模型 |
| 2. UI设计 | Design | 暗色主题、组件拆分、信息层级 | 组件架构 + 视觉规范 |
| 3. 核心实现 | Code | 三层架构、自动导航、事务、降级 | 74个源文件 / 5003行代码 |
| 4. 测试验证 | Code | 10个测试文件覆盖核心逻辑 | 可部署的可靠产品 |
| 5. 上线交付 | Code | Vercel部署、在线可体验 | lightpath-bay.vercel.app |
关键洞察:Work 的产出是 Design 的输入(产品方案→UI设计),Design 的产出是 Code 的输入(组件架构→代码实现)。三个模式不是三个独立工具,而是一条流水线——前一步的结论约束后一步的方向。
真实成果 
| 指标 | 数据 |
|---|---|
| 源文件数 | 74 个 (.ts/.tsx) |
| 代码行数 | 5003 行 |
| 测试文件 | 10 个 |
| 数据表 | 10 张 |
| 页面数 | 12 个 |
| 部署状态 |  Vercel 在线 |
| 参赛帖 | 已通过审核 |
技术栈
- Next.js 16 App Router + TypeScript
- Prisma ORM(SQLite 开发 / PostgreSQL 生产)
- NextAuth.js(Credentials Provider + JWT)
- Web Speech API(浏览器原生语音播报)
- AI 多模态视觉识别(真实接口 + mock 降级)
- Vitest(自动化测试)
- TailwindCSS v4 + Vercel 部署
写在最后 
LightPath 不是一个概念演示,而是一个可以体验的真实产品。从"帮视障者导航"这个模糊想法,到 5000 行代码、10 张数据表、12 个页面的可部署应用,TRAE 三模式各司其职:
- Work 负责"想清楚"——产品边界、用户需求、数据模型
- Design 负责"看得见"——UI 体系、组件拆分、交互流程
- Code 负责"做出来"——架构实现、测试覆盖、部署上线
如果你也有一个想做但一直没动手的想法,试试这条流水线:先用 Work 把它拆解成方案,再用 Design 把方案变成界面,最后用 Code 把界面变成产品。
你的想法是什么?你最想用哪个模式启动?欢迎评论区交流! 